解读:Y2A-Auto——YouTube 到 AcFun / bilibili 的自动化搬运流水线
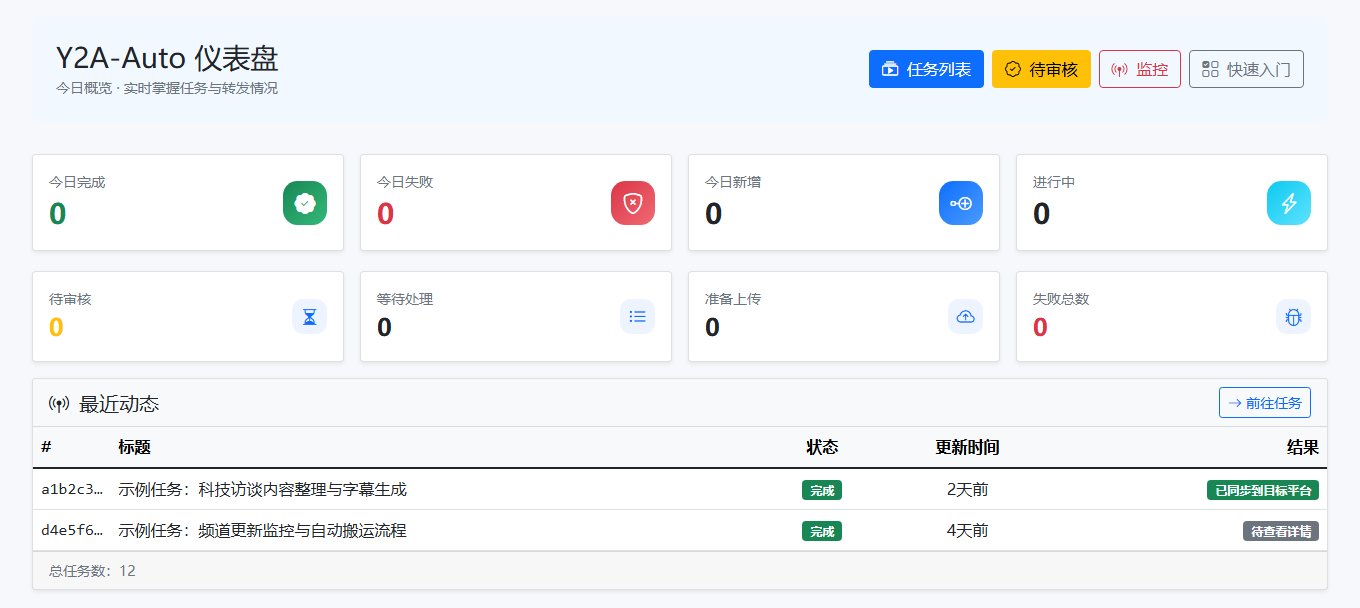
本文是对开源项目 Y2A-Auto 的摘要与评论。抓取时仓库约 ★4042、forks≈685、open issues≈13;语言 Python(3.11+),许可证 GPL-3.0;最新 Release 4.11.0(约 2026-10-20)。插图来自仓库仪表盘截图;部署与配置以仓库 README 为准。
版权与平台规则:自动「搬运」极易踩源视频版权与各站社区规范。请只处理你有权分发的内容(自有素材、明确授权、平台允许的转载协议等),并遵守 YouTube / AcFun / bilibili 条款与当地法律。下文谈工具能力,不是教你未授权搬运或绕过版权检测。
这篇在说什么
Y2A-Auto 的名字可以拆开读:YouTube to AcFun(以及 bilibili)的Automation。它不是单一下载脚本,而是一条一体化流水线:从 YouTube 下载,经 ASR 字幕、翻译、质检、烧录,到 AI 生成标题 / 简介 / 标签 / 分区,可选内容安全审核,再上传 AcFun / bilibili(可双发)。旁边还挂着 Web 管理后台、频道与关键词监控、多渠道通知,并支持 Docker 与本地、CPU / GPU 编码。
对没做过译制运营的人,容易低估后半段难度。下载往往只是起点;真正耗人的是字幕能不能看、分区合不合规、账号会不会被风控、夜里任务失败有没有人知道。Y2A 把这些收成可维护的后台,定位更接近「运营工作台」,而不是「再包一层 yt-dlp」。
全文主线可以压成一句:有授权的跨平台分发,需要的是可审核、可通知、可回滚的流水线;没有授权时,自动化只会同步放大风险。 后面先讲谁该用、流水线如何串、部署要注意什么,再谈怎么评价它。
它解决什么问题、谁会用
典型场景有三类。第一类是有合法译制或转载授权的工作室:固定跟几个英文频道,需要稳定出中文字幕版并投到国内站,人工逐条上传已经跟不上更新频率。第二类是自己的频道做「官方中文镜像」:源在 YouTube,国内观众在 bilibili / AcFun,希望减少手工下载、填简介、选分区的重复劳动。第三类是个人创作者处理自有素材的跨平台分发,把转码与元信息草稿从机械劳动里解放出来。
没有授权的场景不该用这类工具去「放大产能」。技术选型上,下载底座与本站 yt-dlp 介绍 同源;Y2A 补的是「译制运营」后半段——字幕、元信息、审核、上传与监控。若你只需要把视频落到本地,先看 yt-dlp 本身通常就够;若你已经每周要处理多条授权内容,后台与监控的价值才会显现。
流水线怎么串起来
据 README,核心模块大致如下。
下载。 用 yt-dlp 拉视频与封面;可通过 CookieCloud 同步 YouTube Cookies,减少手工导出。监控侧支持频道 / 关键词定时抓取,latest 或 historical 模式,命中后入队自动处理;还可按标题关键词过滤,只跟某个系列或题材。代理、线程数、限速与质量上限都能配,避免把出口 IP 打得太凶。
字幕。 Whisper / Voxtral 等做 ASR(自动语音识别,把声音转成字幕文本),再翻译、后处理、QC(质检),可选烧录进画面。字幕变换引擎会处理长行拆分、标点、填充词过滤、幻觉与噪声标签等;质检失败时可以跳过烧录但仍保留文件并继续上传原片,避免整条任务卡死。对译制团队来说,「坏字幕被标出来」往往比「强行烧录一版不可读的字幕」更重要。时间轴覆盖率、间隙与语速一类规则,也会在质量退化时参与判定。
元信息。 用 AI 写标题、简介、标签,并推荐分区;也可固定分区、预设标签。兼容 OpenAI 风格 Chat Completions 与 Responses API,便于接各类兼容网关。标题与简介仍建议人工扫一眼:模型擅长草稿,平台审核与观众观感仍靠人把关。预设标签与「上传者作首标签」等开关,则服务于账号侧的运营习惯。
审核与上传。 支持人工审核、强制上传、阿里云 Green 等内容安全检测;登录保护与暴力破解锁定。目标平台可扫码登录或导入 Cookie;bilibili 投稿接口有 auto / 必剪 PC / Web 等策略,用于应对平台侧接口与风控变化。默认还有「追加转载声明」一类开关,体现作者对合规提示的意识——声明本身不能替代授权,但有助于流程自检。
通知与运维。 企业微信、Server酱、message-pusher;另有可选 Telegram 转发机器人(公共实例可用性不保证,可自建 Y2A-Auto-tgbot)。转码支持 CPU 与 NVIDIA / Intel / AMD 硬编,默认优先 HEVC,失败回退。并发任务与上传数量可配,避免一台机器同时打爆磁盘与平台接口。
解读:产品完成度偏「运营工作台」——难点往往不在下载,而在字幕质量、分区合规与账号风控;人工审核开关是务实设计,默认无人值守全开反而危险。把「能自动」和「该自动」拆开,是用好 Y2A 的前提。
部署时心里要有数
推荐 Docker:docker compose up -d 后访问本机 5000 端口。首次应先配登录保护、平台账号和 YouTube Cookie,并确认持久化目录(config/、db/、downloads/、logs/、cookies/ 等)权限正确。云服务器若要开公网端口,README 明确提醒:密码保护默认可能是关的,且默认走明文 HTTP——更稳妥的是 SSH 本地转发,或先开密码保护再经 HTTPS 反向代理,并把防火墙来源收紧。
Cookie 失效、平台 603 风控、字幕 API 限速、GPU 容器未挂上,都是真实运维问题,而不是「装完就能永远无人值守」。把「人工审核」和「通知」打开,通常比把所有自动化开关拧到最大更耐用。维护项里还有日志清理、下载清理、FFmpeg 路径与自动补齐——这些看起来像琐事,却决定机器能不能连续跑一周而不被磁盘撑爆。Telegram 机器人若要用,优先自建;公共实例在 README 里已写明不保证可用。
怎么看
对有合法搬运 / 译制授权的工作室或个人,这是把 yt-dlp + ASR + 上传脚本收成可维护后台的方案。对没有授权的场景,自动化只会放大侵权风险。若你已经在做跨平台译制,Y2A 的价值在于把「后半段运营」产品化,并用审核与通知把人留在回路里;若你还在评估是否值得自建,先算清楚授权、账号风控与字幕返工成本,再决定要不要上整套后台。工具再完整,也替不了「你有没有权利分发这段视频」这一问。
安装、安全项与 FAQ 见仓库。
使用前先对齐的三件事
第一件是授权:流水线越顺,越不该用来处理你无权分发的片子。第二件是账号策略:投稿频率、出口 IP、实名与客服申诉路径,往往比「再加一个 AI 模型」更能决定能不能持续跑。第三件是人在回路:字幕质检、人工审核、失败通知,是把自动化从「赌一把」变成「可运营」的关键件。这三件事想清楚了,再调 ASR 参数与硬编开关,通常更不容易走弯路。
若你的团队已经有半套脚本(下载归下载、上传归上传),Y2A 的迁移成本主要在配置与习惯,而不在从零学概念;它做的是把散落步骤收进同一后台,并补上监控与通知。反过来,若你还没有稳定授权来源,先解决内容侧问题,比先部署 Docker 更重要。
读完可以怎么做:在有授权的前提下,用 Docker 起一份实例,先只开人工审核与通知,用一条短视频走通「下载 → 字幕 → 上传」;确认 Cookie、分区与字幕观感可接受后,再逐步打开监控与自动模式。公共 Telegram 机器人不必依赖,需要时再自建。细节仍以仓库为准。