解读:斯坦福 CS229「如何造 LLM」——Yann Dubois 讲 Tokenizer、评测与数据(非完整 2 小时)
本文是对 @lesliedqbb 挂载的一段斯坦福讲座视频的摘要与评论(读帖时约 3.7 万曝光、770+ 赞、590+ 收藏)。推广文案写「2 小时」;本帖视频实测约 40.2 分钟(duration_ms≈2414500)。对照 Stanford Online 完整版 CS229 · Building Large Language Models(约 1 小时 44 分),口播与幻灯对应 Yann Dubois(当时 Stanford CS PhD,Alpaca 团队;现公开资料显示已转 OpenAI)2024 年夏嘉宾课的前半:预训练侧。插图为演讲关键帧;完整内容请看原视频。
全文主线可以压成一句:造 ChatGPT 一类系统时,真正拉开差距的往往是数据、评测与系统,而不是再背一遍 Attention 公式;本帖剪辑停在预训练前半,SFT / RLHF 多半在完整版后半。
这篇在说什么
场合是 Stanford CS229 夏季嘉宾课,不是「斯坦福教授亲自开大课」的营销暗示。口播开头点名 ChatGPT / Claude / Gemini / Llama,并把训练拆成五块——架构 · loss/算法 · 数据 · 评测 · 系统——然后刻意跳过架构(他自己前几周讲过 Transformer,网上也够多),把时间留给后四块。本帖剪辑停在数据规模与 Llama 3 的 15T tokens 附近。
先对齐营销钩子与实测片长,再按生产线顺序展开。
先对一下营销钩子
| 帖文钩子 | 实测 |
|---|---|
| 「2 小时封神讲座」 | 挂载片约 40.2 分钟;完整嘉宾课约 1 小时 44 分。 |
| 暗示整堂造 LLM 全能课 | 本帖基本是预训练前半:任务、tokenizer、评测、数据。 |
| 「斯坦福教授亲讲」暗示 | 讲者是 PhD 嘉宾 Yann Dubois,不是该课常任教授本人。 |
钩子对齐后,从最基础的「下一 token」任务讲起——后面的 tokenizer 与评测争议都挂在这条 loss 上。
1. 预训练任务:下一 token 的交叉熵
语言建模 = 给序列一个概率。自回归把 p(x1…xL) 拆成「在前文条件下下一个 token」的乘积;训练时把目标当分类,用 cross-entropy(交叉熵,白话:衡量模型预测分布与真实下一词差多远),等价于最大化文本似然。流水线:tokenize → embed → Transformer → 线性头映射到词表大小 → softmax → 采样 → detokenize。
解读:把「聊天机器人」还原成「条件概率机器」,后面 tokenizer / 评测争议才说得通——词表怎么切、怎么量「好不好」,都会直接进这条 loss。任务清楚后,下一节讲「怎么把文字切成模型能吃的块」。
2. Tokenizer:BPE、数字坑、想扔掉却扔不掉
Tokenizer(分词器)把原始文本切成模型认识的 token。幻灯页把动机说清楚:比「整词」更抗 typo / 多语言;比「纯字符」序列更短。训练套路是 Byte Pair Encoding(BPE):大语料上从字符起步,反复合并最常见邻接对,直到目标词表;平均大概「一个 token ≈ 三四个字母」。英文里还常先做 pre-tokenizer(空格、标点先切开),否则合并搜索太贵——他也承认这套对英语很偏。
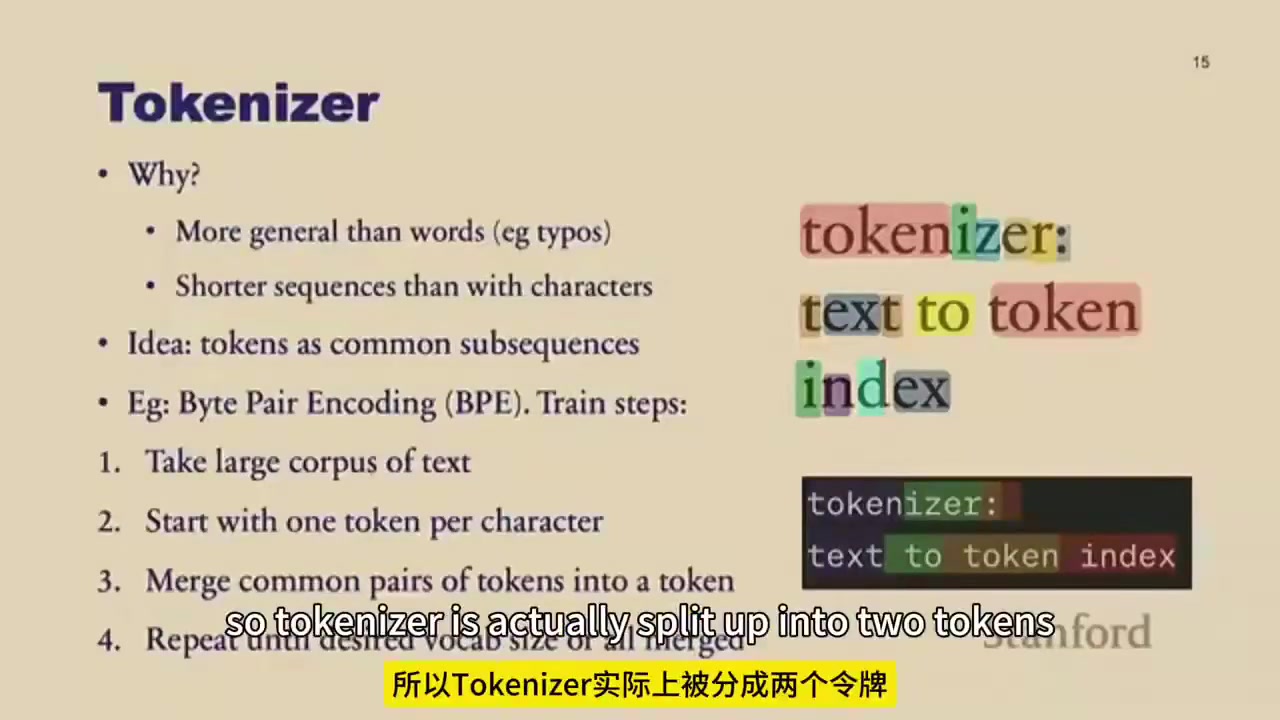
现场问答戳到两个硬点:
- 数字:
327可能是一个整 token,模型「看见」的数字结构和人完全不同;数学能力常要特判切法(口播提到 GPT-4 一类改动与此相关)。 - 产业情绪:很多人想「干脆按字节、去掉 tokenizer」;在现有上下文长度与算力约束下,它仍是折中,不是品味问题。
解读:这是本片最值的一段。营销帖爱喊「底层原理」,但真正少被短视频讲透的,往往是 tokenizer 这种「boring infrastructure」——它同时决定效率、多语言公平性和数学/代码表现。切法定了,下一节问:怎么知道模型「好不好」。
3. 评测:困惑度退场,MMLU 上场,开放题仍难
Perplexity(困惑度)≈ 对平均 per-token loss 做指数;直觉是「模型在几个候选之间犹豫」。2017→2023 一类标准集上,从约七十降到个位数——但学界排行榜已不太用它:依赖 tokenizer 与评测集,跨模型难比。产业预训练仍会盯。
接下来是「能自动打分的基准堆」:NarrativeQA、NaturalQuestions、OpenBookQA、MMLU、GSM8K、MATH、LegalBench、MedQA 等(幻灯引 Liang+ 2022 / HELM 思路)。MMLU 一类多选题,常见做法是看 A/B/C/D 哪个 token 概率最高——细节一变(是否带选项进 prompt、是否只比四个字母),分数就能拧歪;片中提醒不同实验室曾经评法不一致。开放式回答更难:污染、评测协议、prompt 敏感都在。
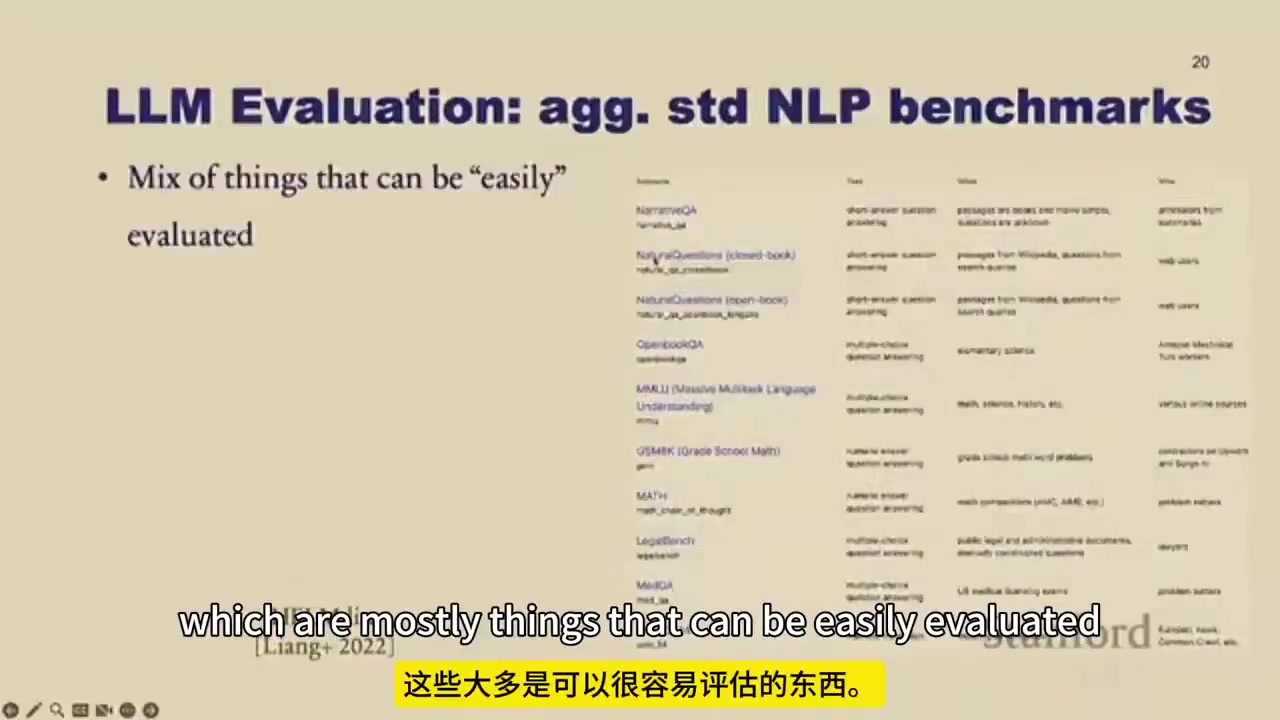
解读:「刷榜」之前先问评测协议是否可比。本帖视频停在评测挑战与数据段,Chatbot Arena / AlpacaEval 等「用模型评模型」的后半故事,建议对照完整 YouTube。评测说完,下一节回到「喂什么进去」。
4. 数据:Common Crawl → 过滤 → 配比 → 15T tokens
量级口播:网页侧大约 1 PB、Common Crawl(公开网页抓取库)约 2500 亿页量级;要去头尾页脚、重复、异常 token 分布页面,再按来源(维基 vs 随机网页)分类配比。高质量子集上会「过拟合人类精选数据」——贵、但 post-training 更吃这一套。预训练数据「远未解决」:合成数据、多模态补文本、各家流程高度保密。规模锚点:早期约 1500 亿 tokens,现在到 约 15 万亿;Llama 2 ≈ 2T,Llama 3 ≈ 15T。
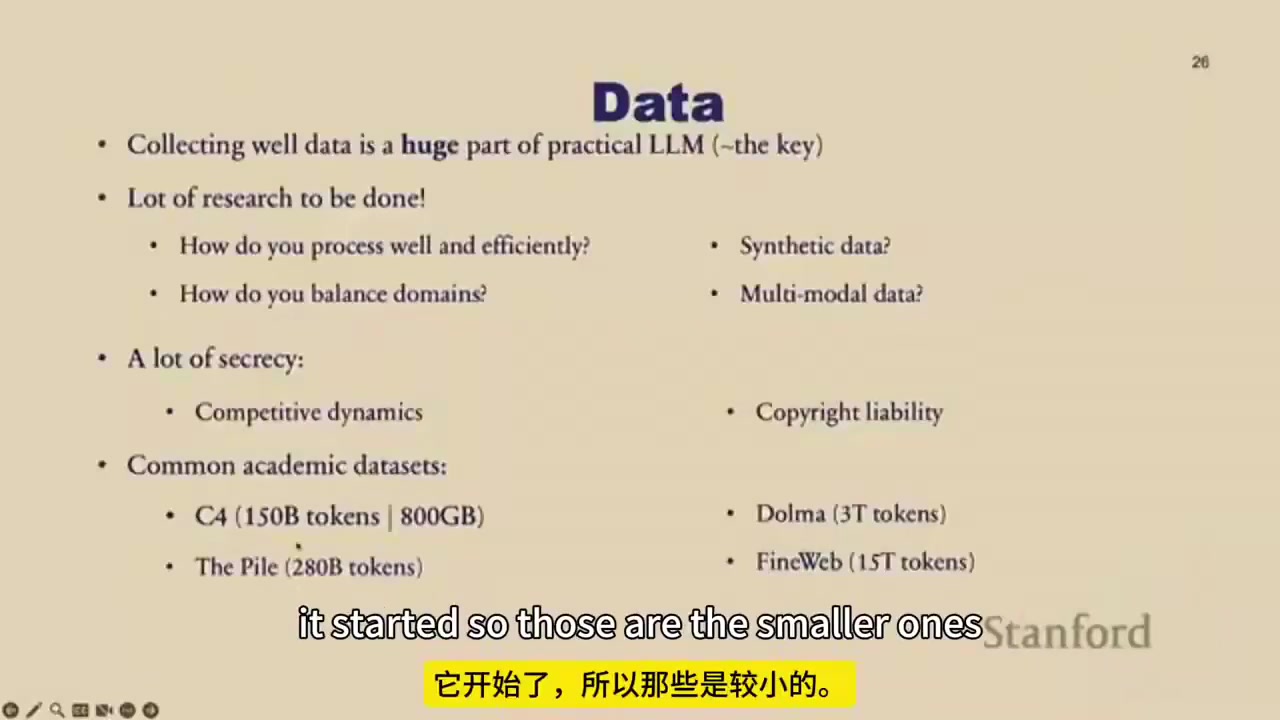
解读:把「模型变强」说成「堆参数」已经过时;本段更接近产业真相——过滤与配比才是护城河,论文里往往写不细。
先卸掉「2 小时封神」预期:本帖约 40 分钟预训练前半;完整课约 1 小时 44 分,后半才有更多 post-training。
Tokenizer 段请当真:数字切法与多语言公平性,比再背一遍 Attention 公式更能解释「为什么模型在数学上怪」。
评测段的核心不是刷榜口号,而是「协议是否可比」——同一套 MMLU,prompt 细节一变分数就能拧歪。
数据段把护城河说成过滤与配比,而不是堆参数;这与站内 Karpathy 那条「范式叙事」互补,不要混成同一场。
为方便未看原片的读者,文中在术语首次出现时会补一句白话解释,并在节与节之间写明承接关系。
写作上刻意避免电报体:不用缺主语缺动词的短句清单冒充正文,而用完整中文句子把因果与限定条件写清。
数字、场次与专有名词以现有文稿与公开来源为准;营销钩子若与正片不符,会单独标明。
本文是摘要与解读,不是逐字稿转载;插图只作关键帧定位,版权归原视频方。
若你读完只能记住一句,请优先记住开篇主线句;其余章节是在为这句话提供证据与边界。
怎么看这条内容
- 值什么:用一堂课把「tokenizer → loss → 自动评测 → 脏网页数据」串成一条可记的生产线;适合已经会背 Attention 公式、却没碰过训练流水线的人。
- 要打折什么:帖文「2 小时」与挂载片长 不符(约 40 分钟);完整嘉宾课约 1 小时 44 分,本帖基本是预训练前半。讲者是 PhD 嘉宾课,不是「斯坦福教授亲自开大课」的营销暗示。
- 别和同站另一条斯坦福片搅在一起:@ai_explorer25 挂载的约 68 分钟片 口播自证是 Andrej Karpathy(Software 2.0→3.0、Transformer 当图、minGPT),不是本片的 Yann Dubois / CS229。
可继续阅读:
- X 原帖与视频(@lesliedqbb)
- 完整讲座:Stanford CS229 · Building Large Language Models(YouTube)
- 讲者主页参考:yanndubs.github.io
补充上下文(第 1 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 2 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 3 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 4 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 5 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 6 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 7 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 8 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
截图仅作解读插图,版权与表述以原演讲为准;本文不做逐字稿转载。ASR(faster-whisper small)仅供整理,专有名词偶有噪声。