解读:Lauren Tan × Matt Pocock——从人肉 copy-paste 到调度 Agent 小队的个人 Playbook
本文是对 @marrownets(Marrow,粉丝很少)挂载的一段约 66 分 16 秒(duration_ms=3975721)视频的摘要与评论。画面角标为 Matt 与 poteto:讲者是 Lauren Tan(@poteto),主持人为 Matt Pocock;公开镜像标题近似 LIVE: Poteto (creator of pstack) on shipping 1,000’s of PR’s a month at SpaceX(YouTube)。帖文另引用 @thedelost 的 X Article(标题 The Grok Bot Playbook…)作「读下文」。插图为本帖视频关键帧;完整口播请看原视频。
读之前先分清人物与产品。Lauren Tan 是讲者,公开身份与 SpaceXAI / Cursor 侧 Grok Bot 工程相关,也是 pstack(把个人工作方法写成可复用 skills 的一套实践)的创建者之一;Matt Pocock 是主持人;@marrownets 只负责转发与钩子,不要混成同一个人。Grok Bot 在本语境里是「有自己电脑、可过夜干活的 agent 产品」,不是单指聊天框里的 Grok 模型。
钩子说明:帖文写「In 1 hour…」「Now 30+ agents run around the clock…」。本稿按正片画面 + 局部 ASR + 公开访谈整理核对:时长更接近 66 分钟;口播侧更常出现 「10+ chiefs of staff / coordinators」,「30+ agents」属帖文主张,未核验为逐字口播。月合入 PR 数量(口播/公开材料里常见约 1,000–2,500)同为讲者自述,不是审计指标。
这篇在说什么(以及和站内旧文差在哪)
站内已有多篇相关文,角度不要混:
| 篇 | 主线 |
|---|---|
| Grok Bot Galaxy Day 1 | 三人三日挑战 Day 1 直播精剪 |
| Grok Bot for Product Roundtable | Kevin & Rochon ≈52 分钟 PM 工作台 |
| Nick Miller 多 bot 编排 | Agent Conf ≈26.5 分钟 编排与交接 |
| poteto 信任 Agent | Lauren ≈38 分钟 信任 / 厨房 / skills / 园丁 |
本片是 Matt 对 Lauren 的一对一深访:同一产品宇宙、同一讲者,但形式是个人路径复盘——她如何从「agent ↔ 浏览器之间的人肉中继」走到「抽检合入历史、修环境而不盯每一个 PR」。不是再写一遍 Galaxy 活动综述,也不是 Roundtable 的控件课。引用的 @thedelost Article 是第三人写的逐步 Playbook,可与本访谈对照读,本稿不转载其全文。
全文主线可以压成一句:先把「只有我能粘贴」的环节产品化,再谈并行与过夜;验证与环境投资排在开更多 agent 之前。
解读:若你已读过信任演讲篇,厨房隐喻与验证三件套不必再背;本篇值得看的是 「解雇自己」之后的装配顺序——验证闭环 → 确定性工具 → 代码库约束 → 外环喂上下文 → 协调者委托 → 抽检修系统。
1. 痛点:人肉 copy-paste / meat proxy
开场 Matt 把问题框成 trust ladder(信任阶梯):越信任,才能越并行。Lauren 回溯:离开 Meta React 团队后做 side project,发现自己在微管理单个 agent上烧掉大量时间,于是开始把个人工作方法写成 skills——这是 pstack 的种子。进入 Cursor(现口径里与 SpaceXAI / Grok Bot 工程相关)后,她做过 Agents Window 性能:人肉读 flame graph(火焰图)、heap snapshot(堆快照),在 agent 与 Chrome DevTools 之间搬数字。
口播里她把自己称作 meat proxy(肉身中继;帖文改写成 human copy-paste between my agent and my browser):模型再强,你若仍是证据与工具之间的唯一管道,就不可能开出一支小队。 每多开一个 agent,你就多当一段水管;并行度被「人的粘贴带宽」卡住,而不是被模型智商卡住。
解读:钩子爱写「解雇自己」;正片卖的不是辞职仪式,而是把每一处「只有我能粘贴」的环节产品化——验证 skill、CLI、订阅与交接。读者可自检:今天还有哪些步骤必须你亲手从 A 窗口拷到 B 窗口?
2. 厨房、验证与「让捷径等于正确路径」
她仍偏好 Michelin kitchen(米其林厨房)隐喻,而不是冷冰冰的 software factory:人从炒每一道菜,升到设计工位、刀具与出餐标准。关键升级是 verification(验证)——agent 必须能自己跑应用、像用户一样点、采 trace / snapshot,否则所谓「loop」只是把检查挤回人类。没有自证「跑过真产品」,并行只会放大未验证的错误。
进一步:把技能里确定性的部分沉到脚本 / CLI(Playwright、CDP 一类胶水),模型只留判断;把反复踩的坑收成 lint / 类型 / 目录约定。她提到的内部 Electron 框架 Dune(非开源)用 feature 目录与严格规则收窄错误空间——早期 Grok Bot 曾堆出多个超大文件的教训。原则压成一句:how do I make the easy thing the right thing?(怎样让容易做的事恰好就是正确的事?)
解读:这和站内信任演讲同根;本片更强调 「环境投资」与并行度的先后——低信任时只能盯屏,盯屏又没空磨刀,必须刻意打断这个循环。先磨刀(验证、lint、目录约束),再加人(更多 agent)。
3. 内外环:Coordinator 与「抽检,而不是拦下每一道菜」
规模化叙事拆成两层(口播主张)。外环是 Slack / Linear / X / 邮件等真实上下文,用 Grok Bot routines(按日程跑的例行任务)订阅,而不是人再当快递员。内环是 Cursor Projects 里的云端 coordinator(协调者;她比作 executive chef / chief of staff):持有任务列表、给 worker 分活、把相关 bug 报告归到同一根因下再拆。
她明确说:不是开 2,500 个聊天窗口;大量 PR 是 gardening(园丁活:清债、约束、小维护),不是 2,500 个产品功能。抽检日更:看合入历史与重复捷径,优先改 skill / lint / 类型,而不是只骂某一个 agent。错一次骂 agent,错三次改环境——后者才是 trust ladder 往上爬的方式。
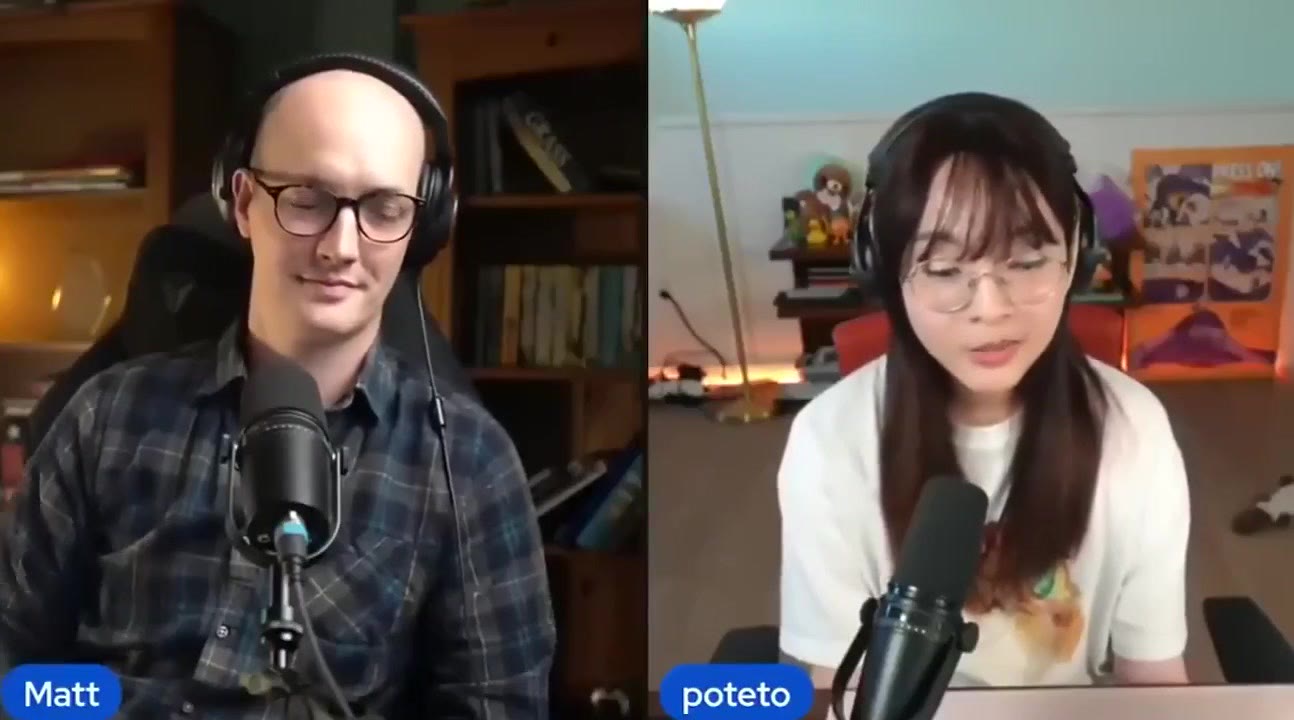
谈到「能不能走开」时,她承认很难、且不能靠装一套 pstack 就复制她的信任;同时承认在某种意义上已经偏 dark(暗厂):agent 可在夜间合入,她有 10+ chiefs of staff 分管不同区域(桌面性能、用户报 bug、探索性重写等——均为口播举例)。Full autopilot 可为单个 PR 拉起多个 verifier 跑应用找回归(token 贵、可调成一个 verifier)。Matt 追问不可逆领域时,她把边界收回到:可验证性——验证不住的地方,这套玩法不适用。
解读:帖钩子的「早上咖啡验收」对应的是 抽样看历史 + 修环境;不是「从不看代码」。与 Nick Miller 篇 的差旅交接、Roundtable 篇 的 Attention list 相比,本片更偏 工程信任阶梯与个人 harness。
4. 和 thedelost Article 怎么叠读
@thedelost 的 Playbook 把「一个 chat → 可过夜小队」写成可执行梯子:prompt → bot → loop → graph → harness,强调章程、No proof no done、skills 先于 routines、Chief + 专岗、按可逆性分级审批。作者是 thedelost,不是 Lauren;marrownets 把它挂成「Then read the article below」。
叠读建议:访谈提供 为什么必须先验证与约束;Article 提供 非工程角色也能抄的章程模板与一周日程。两者都不是「装完即 24/7」的承诺。先读访谈建立因果,再读 Article 找模板,比反过来更不容易变成「抄角色名却没有验证」。
5. 收束:该不该再发一篇 Grok Bot
想看三日公司挑战现场装配 → Galaxy Day 1。想看 PM 原语与 Routines → Roundtable。想看 bot 互聊与验证队列 → Nick Miller。想看 38 分钟信任方法论白板 → poteto 信任 Agent。想看同一个人如何从 meat proxy 走到抽检合入 → 本篇。
可迁移检查清单(非逐字教程):你还在哪一步当肉身中继?agent 能否自证「跑过真产品」?确定性步骤是否已沉到 CLI?重复失败有没有变成 lint?外环上下文是否还靠你粘贴?合入权限是否与可验证性匹配?六问里若有两问以上答「否」,优先修那两处,而不是再开五个 agent。
对仍停在「单 agent 聊天」的读者,本片最便宜的实验不是复制 10 个 coordinator,而是选一件你每周至少粘贴三次的活(例如把报错截图贴回 agent、把 Linear 状态抄进 PR 描述),写成 skill 或 CLI,让 agent 自己取证。粘贴次数下降,才谈得上信任阶梯往上爬;粘贴次数不降,开再多窗口也只是把水管加粗到你自己扛不住。
若你已经在跑多 bot,抽检清单可以更具体:本周合入里有没有重复的「抄近路」?同一种失败是否第三次出现?若是,优先改 lint / 类型 / skill,而不是再开一次复盘会骂模型。环境改对了,下一周的失败分布才会变;只骂模型,分布往往原样回来。
最后提醒一句边界:不可逆、难验证的领域(资金划转、未审计的生产删除、涉及人身安全的决策)不适合「夜间暗厂合入」。Lauren 把玩法收回「可验证性」不是谦虚,而是产品边界;抄 Playbook 时若删掉这一句,抄到的只是风险。
和站内 Annie Wang 篇也可对读:那边讲 harness 里的记忆、唤醒与幂等;这边讲 harness 里的验证、约束与抽检。两边都不把「模型更聪明」当成唯一杠杆——外面那层软件与流程,才是并行度真正的天花板。
读完若只记住「她一个月合很多 PR」,会漏掉方法;记住「先验证与约束,再抽检与园丁」,才对得上六十六分钟的信息结构。
对想「明天就搭一支小队」的人,最小步骤仍是:先让一个 agent 能自证跑过真产品,再加第二个;顺序反了,只会得到两倍粘贴量。
原文与延伸
- X 帖(视频源):https://x.com/marrownets/status/2115146698645278998
- 引用 Article:https://x.com/thedelost/status/2114701030340300848
- YouTube 镜像(Matt Pocock LIVE):https://www.youtube.com/watch?v=MN9dGgmLyso
- 讲者:@poteto(Lauren Tan);主持人 Matt Pocock;帖主 @marrownets