解读:Karpathy 斯坦福演讲——Software 3.0、把 Transformer 当图、再删到 minGPT
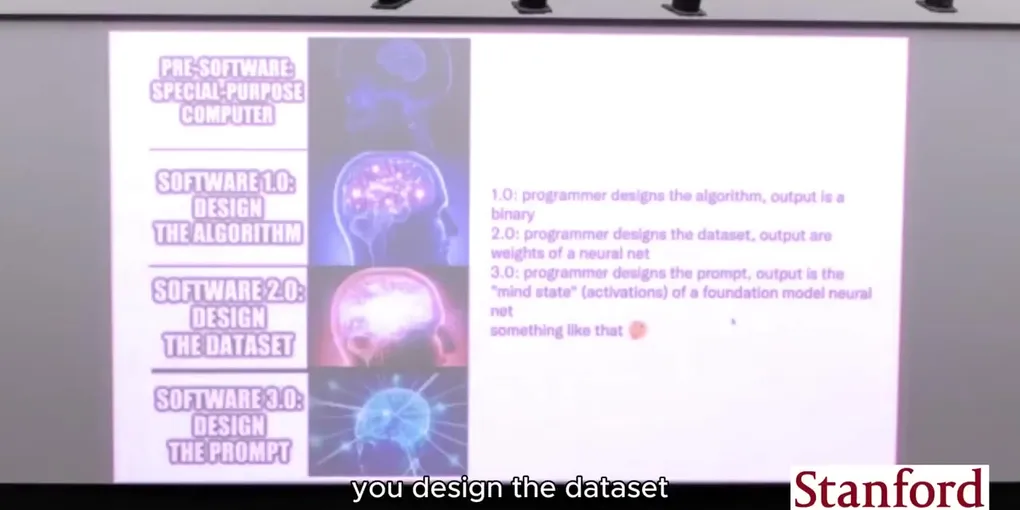
本文是对 @ai_explorer25 挂载的一段约 68.5 分钟(1280×720)斯坦福现场演讲的摘要与评论(读帖时约 1.36 万曝光、170+ 赞、270+ 收藏)。帖文写「Karpathy 1h AI engineering:LLM→Prompt→Agent→Loop→Graph,Delete everything, keep Graph」——口播开场自证讲者确是 Andrej Karpathy(七年前斯坦福 PhD → OpenAI → Tesla Autopilot →「一周前刚回 OpenAI」;还做过 ConvNetJS、写过博客、拍过 YouTube)。时间锚点大致在其 2023 年初再入职 OpenAI 前后的 TreeHacks / 斯坦福 keynote 一类场合。不是 CS229 的 Yann Dubois,也不是 CS25 的 Steven Feng 主讲节。插图为演讲关键帧;完整内容请看原视频。
全文主线可以压成一句:编程范式在换栈——从写算法,到用数据引擎堆权重,再到用自然语言 prompt 配置「基础模型这台通用文本计算机」;后半把 Transformer 拆成有向图上的消息传递,并现场删到 minGPT 式 decoder-only。
这篇在说什么
场合是斯坦福现场 keynote,听众多半已经听过公式,缺的是一张「范式表」和一个「计算图直觉」。前半讲 Software 1.0 → 2.0 → 3.0:为什么识别图中有猫写不出稳健算法、为什么下一词预测 + prompt 变成新栈。后半回顾 Attention Is All You Need,用「浅而宽的消息传递图」解释为何 Transformer 吃得下规模,再把实现删到可动手的 decoder-only。帖文那句「Delete everything, keep Graph」对的是后半,不是工作流编排产品。
先把场景钉住:这是谁、在什么时间、对什么人说话。下一节从最熟悉的「传统编程裂开」讲起。
1. 为何现在最适合 hack:从猫识别到 Software 2.0
传统编程(口播拉到 Knuth / Linux)在「写清指令」上走得很远,但在识别图中有猫这类问题上裂开——你写不出稳健算法。他称下一代栈为 Software 2.0:神经网络不是「又一个分类器」,而是新的编程栈;你通过积累与迭代数据集(data engine,白话:用数据管线代替手写规则来「写程序」)来产出权重。语音识别不必再堆手工流水线,大网 + 大数据 → Whisper 一类系统。
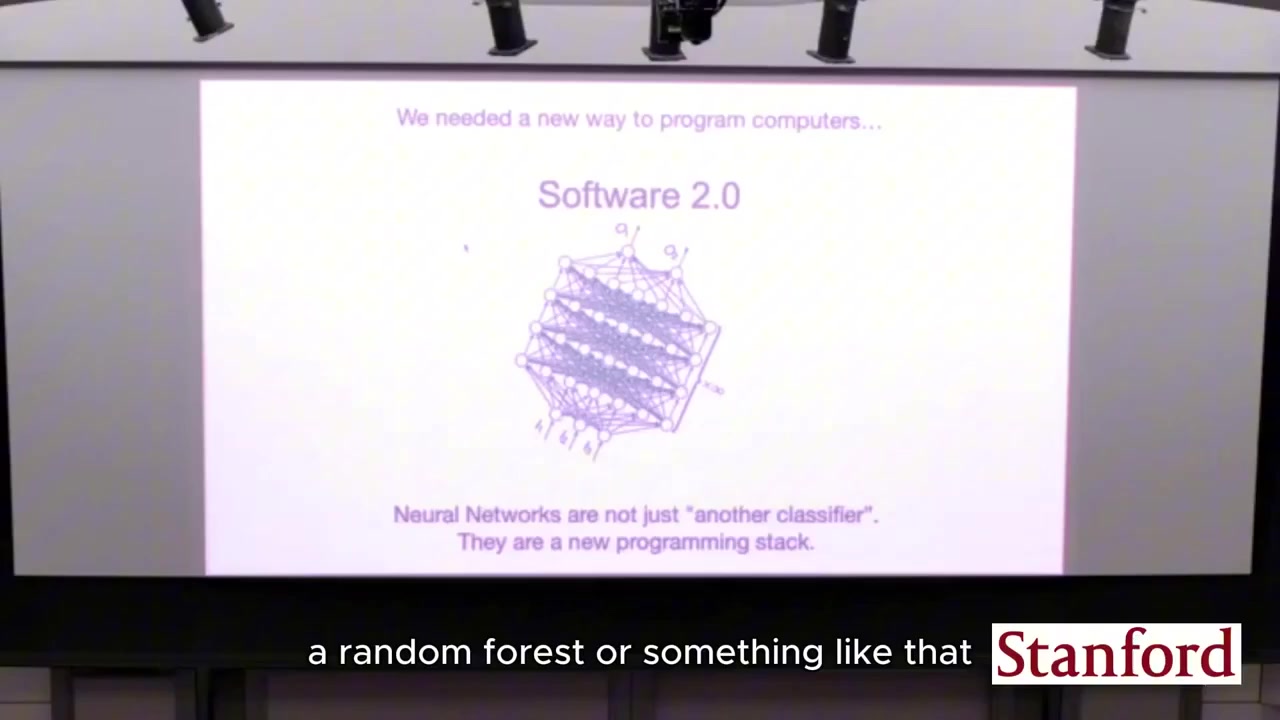
解读:熟悉他旧文 Software 2.0 的听众会觉得这是热身;本场真正的新产品牌是下一层 3.0。热身结束,下一节进入 LLM、思维链与「用英文写后端」。
2. LLM、思维链与「用英文写后端」
大模型被还原成下一词预测;生成即把采样结果喂回上下文。Prompt(提示词)把模型条件到问答模板;Chain-of-Thought(思维链,口播举「Let’s think step by step」一类)把正确率从个位数拉到七十、八十(数学题例子)。再往上:约束「只回一个代码块」驱动终端循环、浏览器/插件扩展记忆、甚至「后端几乎没有 Python、状态机写在 prompt 里」的黑客松项目;并点到当时刷屏的 Bing/Sydney 系统提示泄露段子。
收束成范式表:
| 代际 | 程序员设计什么 | 产物 |
|---|---|---|
| 1.0 | 算法 | 二进制 |
| 2.0 | 数据集 | 神经网络权重 |
| 3.0 | Prompt | 基础模型的「心智状态」(激活) |
口号:最热的语言变成英语。他也半开玩笑说,管人同样靠 prompt。
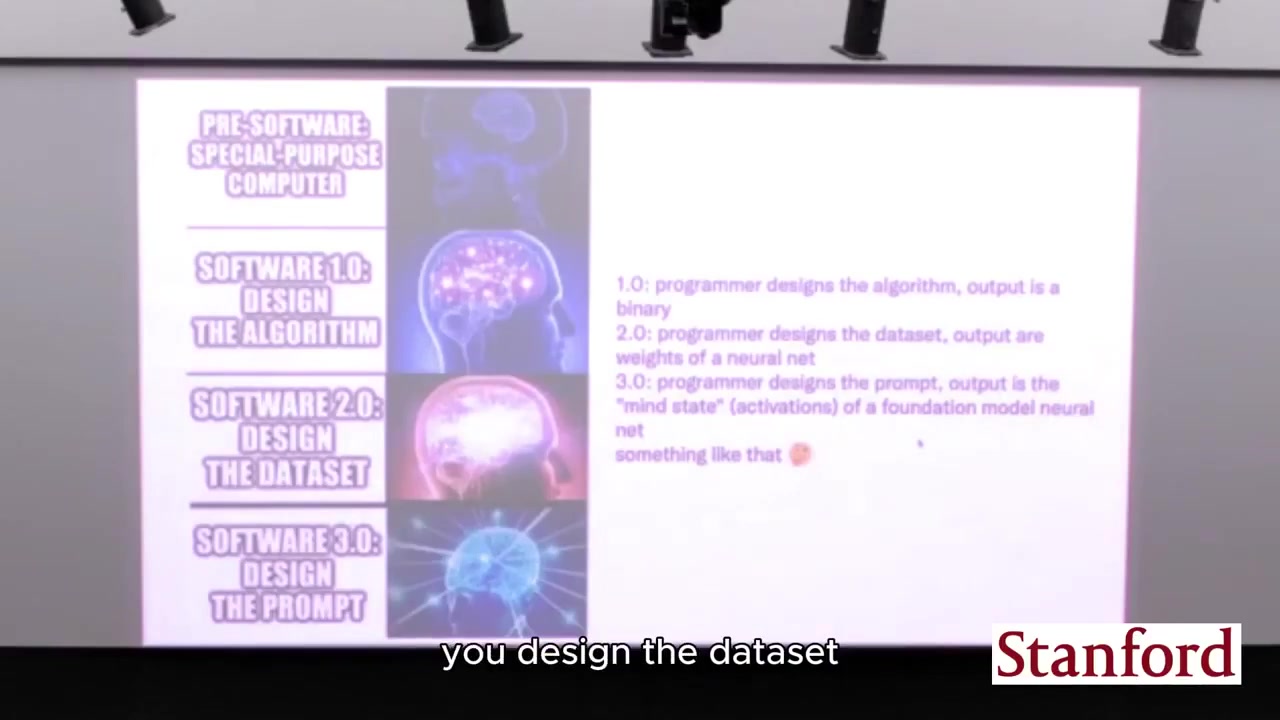
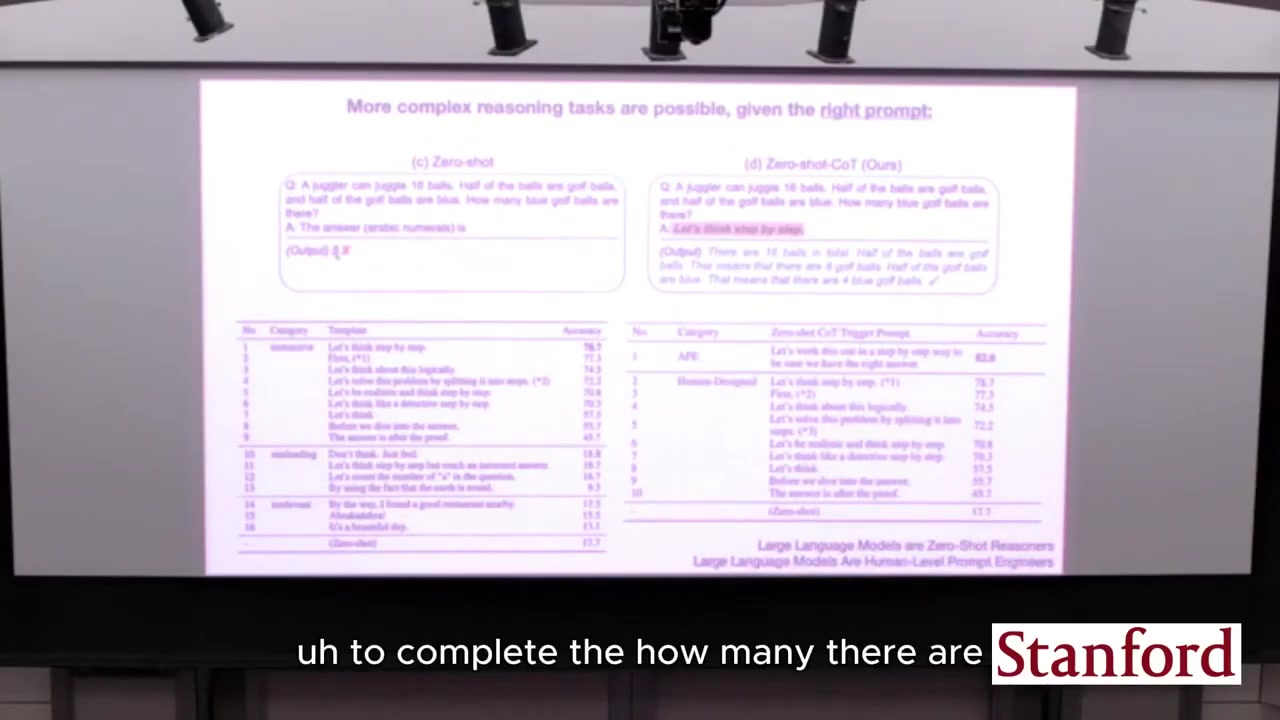
解读:帖文里的 Prompt→Agent→Loop,在本片主要落在「工具循环 + 外部记忆 + 约束输出」,不是后来 LangGraph 产品文档那种 Agent 教材;别用 2025–2026 年的 Agent 词表硬套 2023 语境。范式表立住后,后半换成「为什么 Transformer 吃得下规模」。
3. Transformer:删 RNN,留下注意力;本质是图上的消息传递
后半回顾 Attention Is All You Need:扔掉 RNN(循环神经网络,一步步串行读序列、难并行),只留 Attention + 位置编码 + 残差 + MLP 交错 + LayerNorm + 多头;架构多年来几乎只在 pre-norm 等细节上拧。关键隐喻——在有向图的节点(token)上做数据依赖的消息传递:query/key/value 决定谁跟谁说话;encoder 全连接、decoder 因果三角掩码、cross-attention 从编码器取 K/V。
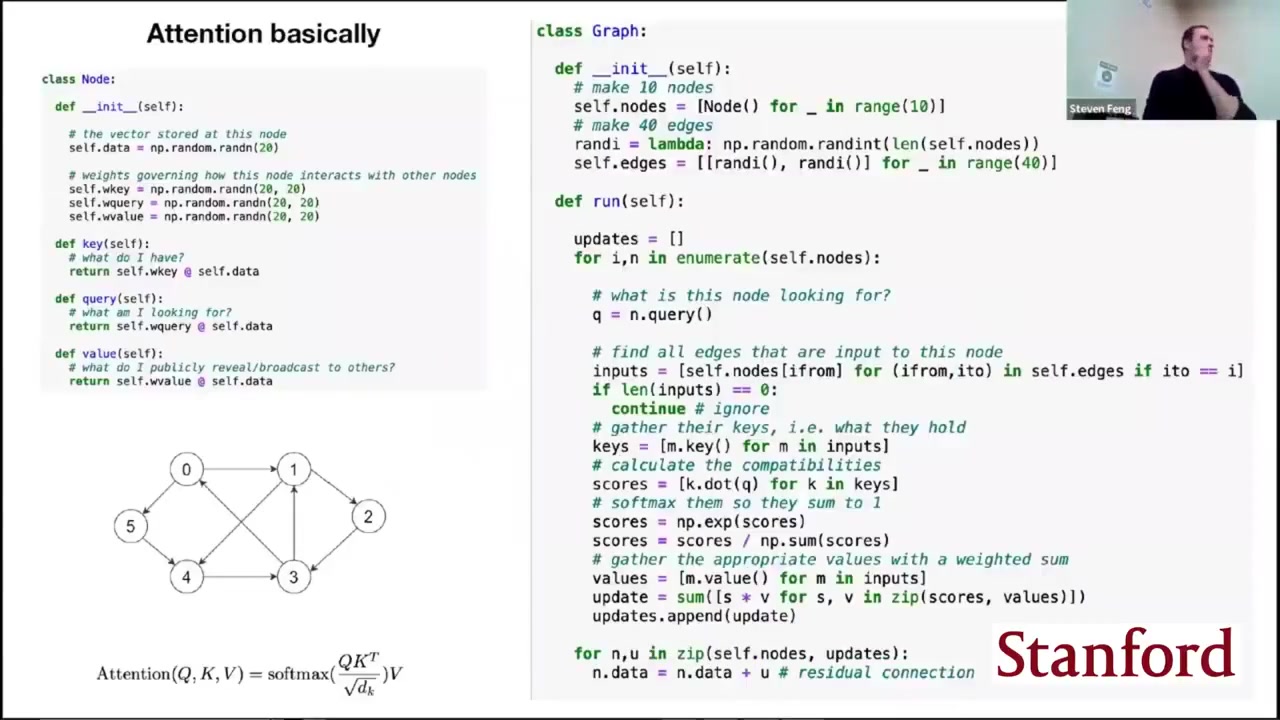
对比 RNN:长而瘦的串行计算图,难并行、难优化;Transformer 是浅而宽的图,监督信号到输入跳数少、残差通路顺、吃得下规模。他甚至说,若自己起名,论文该叫「通用、高效、可优化的计算机」,而不是只强调 Attention。
解读:帖文「Delete everything, keep Graph」最贴这段——先删 RNN,再在实现里「删一行 mask / 删掉 encoder」就能在 GPT / BERT / T5 形态间切换。Graph 在这里是计算图/消息传递图,不是工作流编排产品。图直觉有了,下一节落到可删改的代码。
4. minGPT:decoder-only 落到代码
现场走向极简 GPT:token(词元)与位置嵌入相加 → Transformer block(通信阶段的因果自注意力 + 计算阶段的 MLP)→ LM head。强调有限 block size(上下文窗口长度)、未来 token 必须掩掉,否则泄漏答案;并演示如何改几行得到 encoder-only 或加 cross-attention 的整塔。收尾金句:旧神经网络像专用机;GPT 是运行时可用自然语言程序重配置的通用计算机——程序就是 prompt。
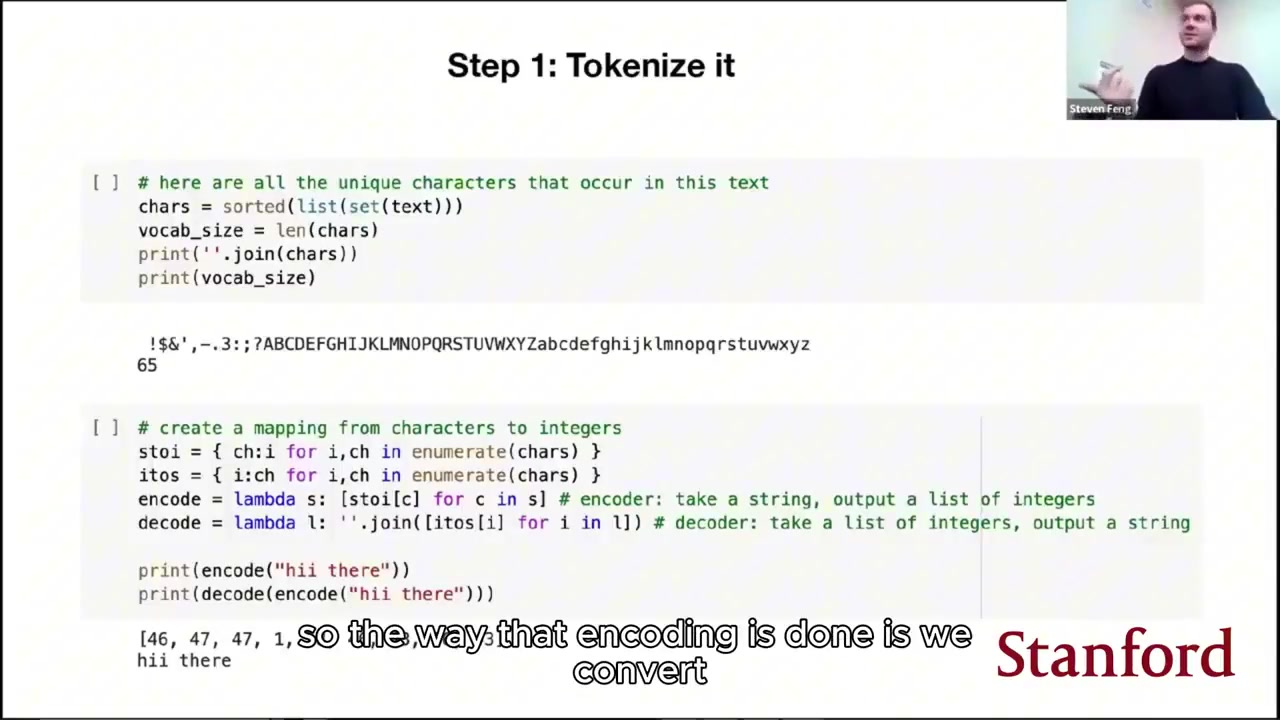
解读:与他公开的 minGPT / nanoGPT 教程同宗;本片价值是把「范式叙事 + 图直觉 + 可删改实现」缝在同一场 keynote 里。
这场是 2023 语境的 keynote:Agent 指工具循环与外部记忆,不是后来的多 agent 编排教材;读的时候请带着时间锚点。
「Delete everything, keep Graph」请落到计算图:删 RNN、删多余 mask/encoder,留下浅宽消息传递——不是删产品功能。
Software 3.0 表的可抄处是「程序员设计什么」这一列:从算法到数据集再到 prompt,帮助解释为什么英语变成热门编程语言。
minGPT 段适合当作动手入口:先看懂因果掩码与 block size,再谈更大系统;不要跳过掩码直接谈 agent。
为方便未看原片的读者,文中在术语首次出现时会补一句白话解释,并在节与节之间写明承接关系。
写作上刻意避免电报体:不用缺主语缺动词的短句清单冒充正文,而用完整中文句子把因果与限定条件写清。
数字、场次与专有名词以现有文稿与公开来源为准;营销钩子若与正片不符,会单独标明。
本文是摘要与解读,不是逐字稿转载;插图只作关键帧定位,版权归原视频方。
若你读完只能记住一句,请优先记住开篇主线句;其余章节是在为这句话提供证据与边界。
对已经会背公式的读者:本场最值得带走的是「浅宽消息传递图」这一个隐喻;它解释了为何同一套注意力块能横向铺开算力,而不是再堆一层更深的 RNN。
怎么看这条内容
- 值什么:Software 3.0 一张表 +「Transformer = 浅宽消息传递图」+ 可动手的 decoder-only 删改路径;适合已经会背公式、却没建立「计算图直觉」的人。
- 要打折什么:片长约 68 分钟,帖文「1h」大致成立;「Agent」一词按 2023 工具循环理解,勿期待完整 multi-agent 教程。部分幻灯/画中画若与其他斯坦福课素材并置,以口播身份为准。
- 别和 CS229 那条搅在一起:lesliedqbb 挂载的 Yann Dubois「造 LLM」 是另一门课、另一讲者(偏 tokenizer / 评测 / 数据),不是本场。
可继续阅读:
- X 原帖与视频(@ai_explorer25)
- 相关公开材料:Karpathy Software 2.0 博文;karpathy/minGPT / nanoGPT
补充上下文(第 1 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 2 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 3 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 4 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 5 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 6 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 7 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 8 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
截图仅作解读插图,版权与表述以原演讲为准;本文不做逐字稿转载。ASR(faster-whisper small)仅供整理,专有名词偶有噪声。