解读:Karpathy《How I use LLMs》实用指南——帖文「Harness / Prompts→Agents→Loops→Graphs」不是这场讲座
本文是对 @huxlab 挂载的一段约 2 小时 04 分(duration_ms=7427086,1282×720)横屏视频的摘要与评论(读帖时约 2.1 万曝光、251 赞、302 收藏、52 转发、13 回复)。帖文中文钩子写:Karpathy 把 OpenAI / Tesla 八年经验浓缩进免费两小时讲座;「懒得聊 prompt 技巧」,底牌是 Prompts → Agents → Loops → Graphs;并列出 Harness 环境、带验证的 Loop、规模化 Graph、以及「模型是消耗品、系统才是护城河」等金句。视频来自转载帖 @0xkichiro;源帖还 quote 了 LunarResearcher 的 X Article《Harness Engineering: The Complete Guide…》(那是长文指南,不是本片口播)。
核对后:钩子与正片严重不符。 正片是 Andrej Karpathy 面向大众的实用演示 How I use LLMs(官方约 2:11:12;本镜像略短,约少 8 分钟,内容仍落在同片后大半)。他全程在浏览器里点 ChatGPT / Claude / Gemini / Grok / Perplexity / NotebookLM / Cursor 等产品界面,讲的是怎么当用户把这些工具用好——tokenization 直觉、新开对话、模型档位、thinking 模型、联网搜索、Deep Research、上传文件、Python 解释器与高级数据分析、Claude Artifacts、自定义 GPT、以及 Cursor「vibe coding」。没有把「Harness / Loop / Graph 控制流拓扑」当主线来讲,也不是「Agent 过夜刷出几十个 PR」的工程编排课。帖文那条 Prompts → Agents → Loops → Graphs 话术,与站内已发布的 Karpathy 斯坦福 Software 3.0 摘要 所用营销句高度同构,但那是另一场约 68.5 分钟的斯坦福现场演讲;本帖挂载的是更长的 YouTube 实用片。画面右下角偶见 ANTHROP\C 水印,属于转载包装,不是 Anthropic 主办场次。
本稿依据 X 镜像关键帧 + 本地抽样转写 + 官方章节公开摘要整理,不是逐字转载。插图为草稿目录下关键帧。完整口播请看原帖视频或官方 YouTube。
这篇在说什么
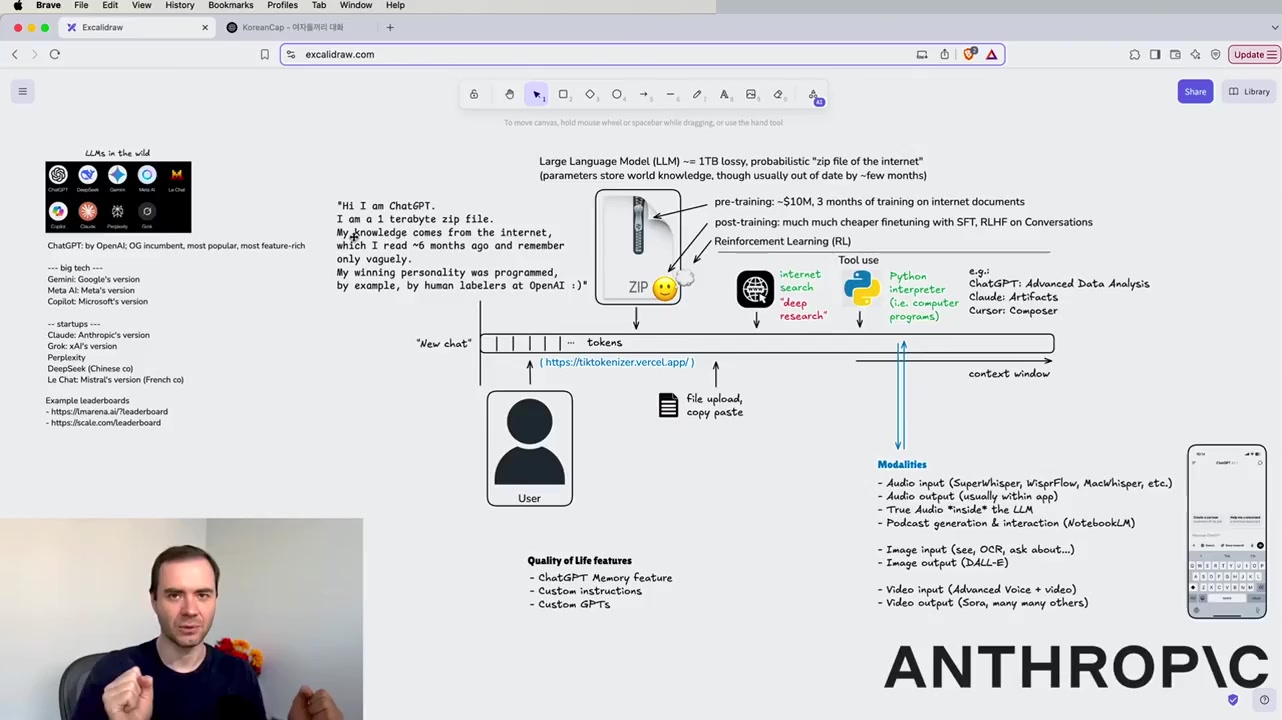
一条主线:把大模型当成一套正在快速长出「工具与外围功能」的产品生态来用——先理解它在吃什么(token / 上下文窗口)、知道什么(预训练压缩 + 知识截止)、再按任务选档位与是否开启「慢思考」,最后用搜索、解释器、上传、Artifacts、IDE 助手把能力接到真实工作流上。
适合谁:已经会打开 ChatGPT,但还分不清「新开聊天为什么变聪明」「为什么要开 thinking」「Deep Research 和普通搜索差在哪」「Cursor 跟网页对话框差在哪」的人。不适合谁:冲着帖文来学「搭 Agent Harness / 画 Graph 流水线」的人——那部分请去看被 quote 的长文,或专门的编排框架教程,而不是本片。
1. 开场:从 ChatGPT 首页看清「你在跟谁说话」
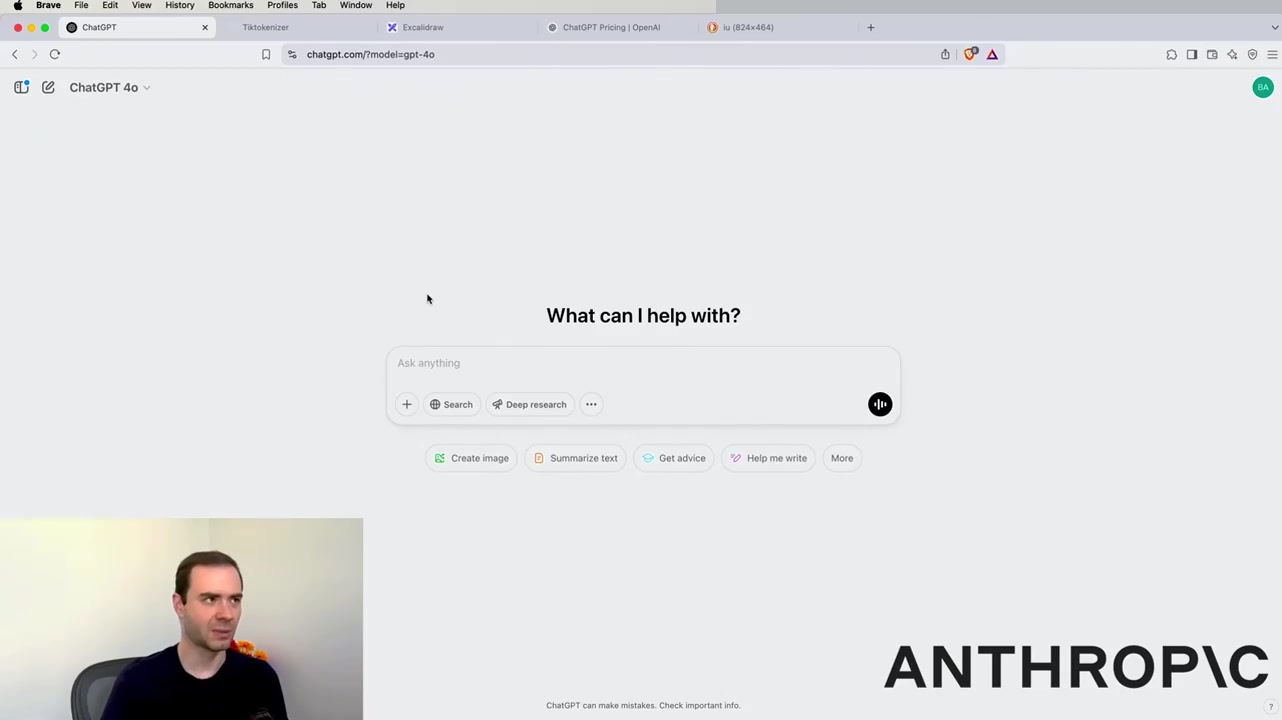
口播把场景钉在 chatgpt.com:2022 年 OpenAI 把「文本框对话大模型」推成全民产品;到录制时点(片中语境已是 2025 年前后的产品形态),同场竞技者包括 Google Gemini、Meta Llama、Anthropic Claude、xAI Grok 等。他强调自己会以 ChatGPT 为例演示,但鼓励对照多家产品与公开排行榜(如 Chatbot Arena)来选模型。
紧接着用 Tiktokenizer 一类工具演示:模型并不按「字」思考,而是按 token(子词块)读写。一整段对话,其实是用户与模型轮流往同一条一维 token 流里写内容;这条流就是 context window(上下文窗口)——白话:模型这一轮能「看见」的工作记忆。点「新聊天」等于清空这条流,从干净的工作记忆重新开始。
解读:很多「模型变笨了」的体感,其实是窗口里塞进了过时任务、跑偏角色或大段无关粘贴。工程上对应的习惯是:任务切主题就新开线程,而不是在同一条长对话里无限追加。
2. 预训练、知识截止,以及「咖啡因问法」这类常识题
他把训练粗分成两段:
- Pre-training(预训练):把大量互联网文本压进参数;结果是模型「好像记得很多事」,但有一条硬边界——knowledge cutoff(知识截止日期),截止之后的事实它没见过。
- Post-training(后训练):用对话数据把模型调成「助手人格」,更愿意按问答格式帮忙,而不是只会续写网页。
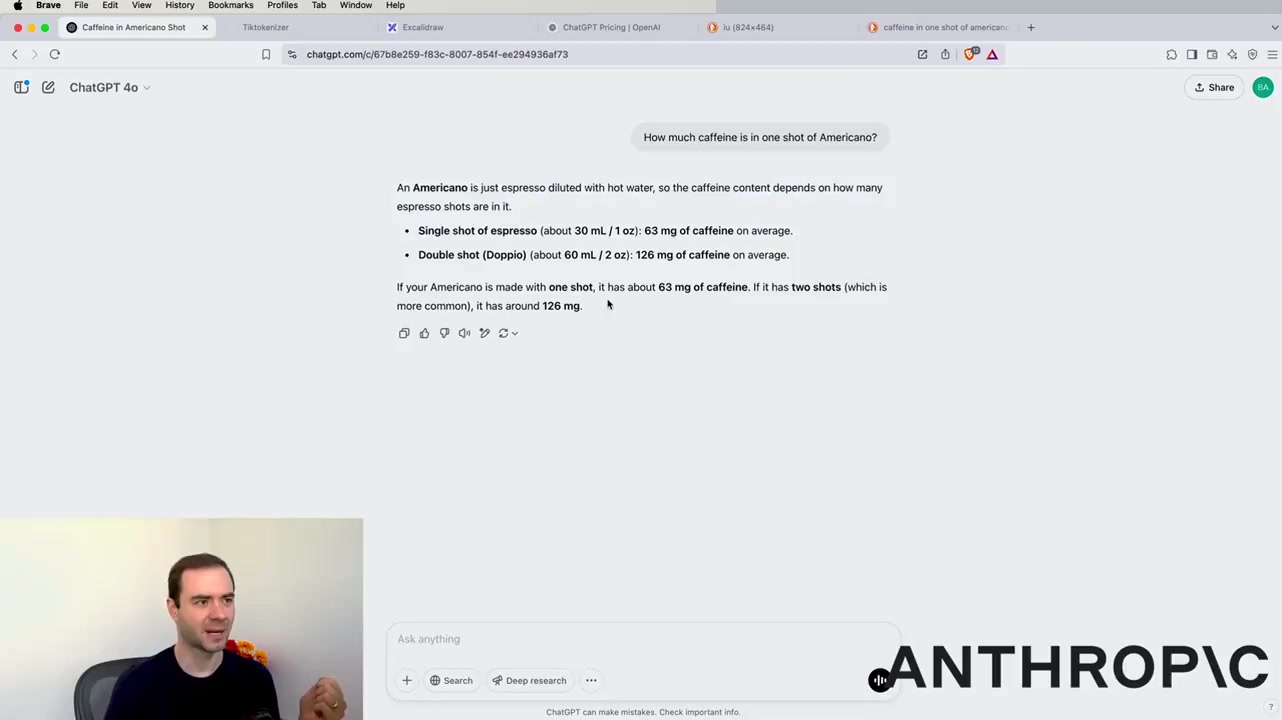
片中用「美式咖啡里有多少咖啡因」这类网上反复出现过的常识演示:模型往往答得像模像样,但本质是概率性回忆,不是数据库查询。口播反复提醒:重要事实要外核验。
解读:把 LLM 当「压缩过的模糊维基」而不是「实时真相源」,是整场最便宜也最难坚持的习惯。后面所有「接搜索 / 接文件」的功能,都是在补这条缺口。
3. 上下文窗口的两个代价:分心与变慢
本地转写在镜像片前段清楚听到他画「cartoon diagram」:新聊天开始一条 token 序列;用户写入 → 回车把控制权交给模型 → 模型吐 token → 特殊结束符再把控制权交回。窗口里的一切都在工作记忆里。
他点出两点实务:
- 窗口太脏会分心:早期无关 token 可能拉低后面采样的准确度。
- 窗口越长,下一步采样略贵、略慢(不一定数量级爆炸,但体感与账单都会累积)。
解读:这不是玄学「清空气场」,而是可操作的产品用法——长项目拆会话、把结论另存、少让模型在同一线程里既写代码又聊八卦。
4. 模型档位、多厂商,以及 thinking(慢思考)模型
他带着看定价页与档位:同厂往往有 mini / 标准 / 更强档;更强通常更贵。然后横向点 Claude、Gemini、Grok:专业档与实验档并存,没有永远的唯一赢家,值得为不同任务保活多个订阅或 API。
重点段落是 thinking models(思考型模型):用强化学习等方式训出「先在内部推敲再答」的习惯——会出现类似内心独白、回退假设、重算的轨迹。代价是延迟(可能到分钟级),收益是数学、代码、硬推理题上更稳。片中拿普通 GPT-4o 与带 thinking 的档位对比同一编程 bug:前者给泛泛调试建议,后者更能钉到具体参数不匹配;同时他也演示 Claude / Gemini / Grok 等有时不靠显式 thinking 模式也能解出来。
解读:可执行分流很简单——客服话术、短改写走快模型;难题、对错可验的题,才把预算留给慢思考。帖文说的「别抠 prompt 形容词」在这里有一半道理,但正片给出的替代方案是换档位与开工具,不是上 Graph 编排。
5. 联网搜索、Deep Research,以及「White Lotus 什么时候播」
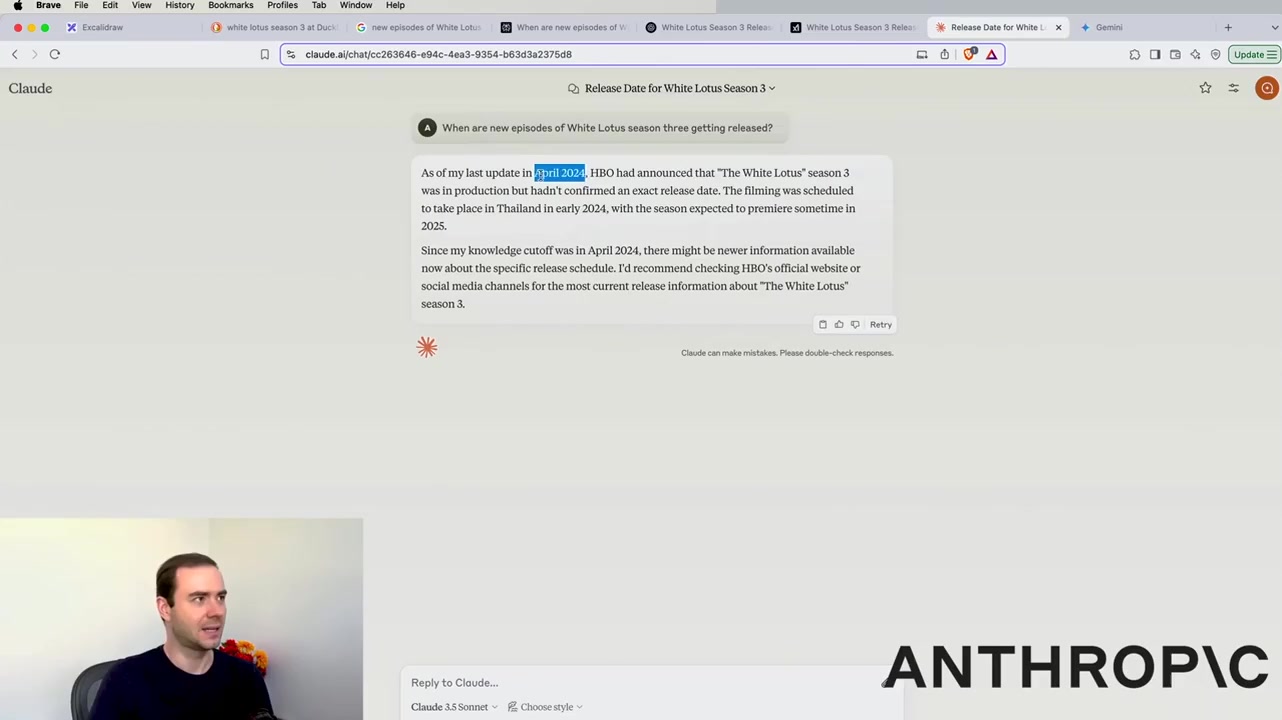
当问题踩在知识截止之后(片中举例剧集档期、市场近况),纯参数回忆会诚实或胡编地说「不知道 / 尚未官宣」。他对比:接了搜索工具的产品可以去抓网页再总结;没接搜索的 Claude / 某些 Gemini 实验档当时就会卡在截止日。Perplexity 被当作「搜索原生」体验的对照。
再往上是 Deep Research:让模型花更长时间、多轮检索与整理,产出接近研究报告的长文(健康成分、公司融资体量等例子)。这已经不是「再写一句更好的 prompt」,而是把时间预算显式卖给你。
解读:产品分层可以记成三档——闭卷回忆 / 单次搜索摘要 / 多分钟深度调研。选题、尽调、医学科普入门可以上第三档,但输出仍要当「带引用的草稿」而不是终审。
6. 上传文件、Notebook 式资料库、Python 解释器
文件上传(PDF、文本、个人化验单、论文)让资料进入当前上下文,然后你可以「对着这份材料提问」。他也演示 Google NotebookLM 一类「左侧资料源、右侧对话 / 衍生产物」的形态:先把基因组基础模型论文丢进去,再聊天或生成导读。
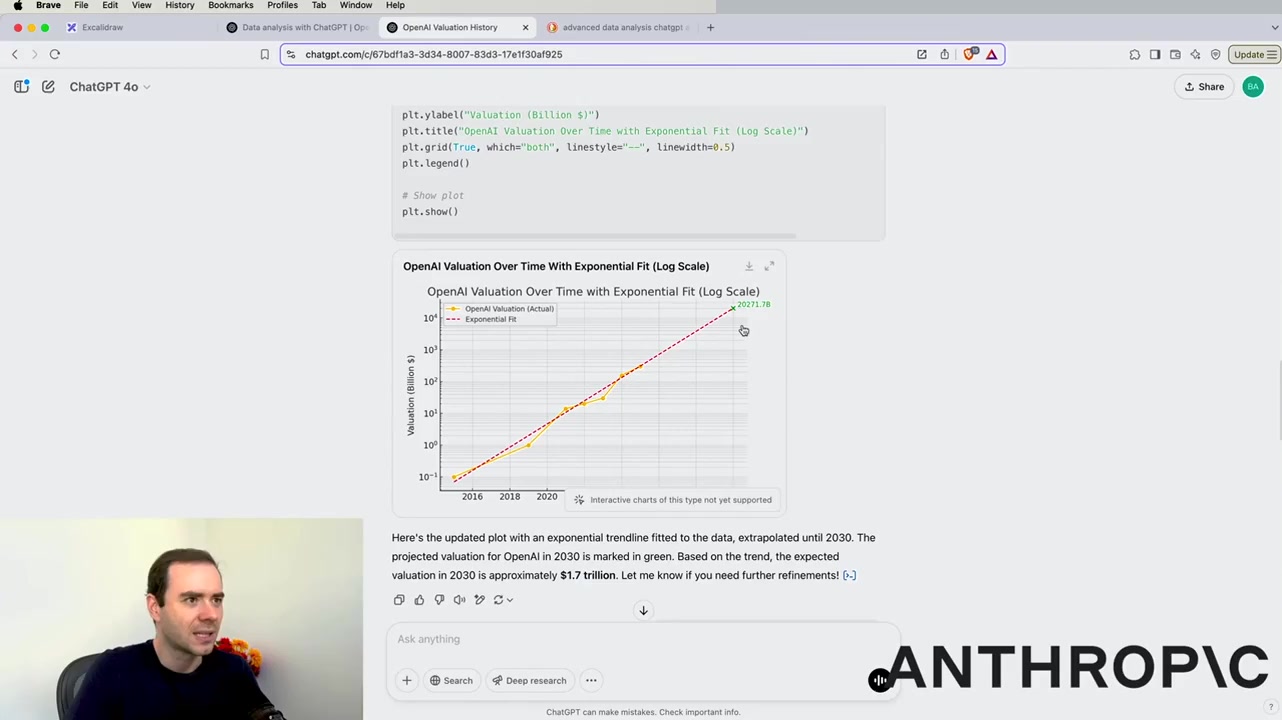
Python interpreter(解释器工具) 让模型在算不动或易幻觉的地方改写代码并执行——大数运算、表格处理、画图。Advanced Data Analysis 段里,他用 OpenAI 估值时间序列做外推,并当场抓出模型展示层与真实变量不一致的坑:图上的标签、打印出的变量、口头总结的「万亿」可能对不上。口播态度很明确——把模型当初级分析师,代码与假设要人审。
解读:工具调用把「会说」升级成「能算」,但也引入新的失败模式:界面美化、单位换算、默默补全缺失点。帖文吹的「有客观反馈的 Loop」在本片里最接近的实体,其实是解释器跑通 / 单测变绿 / 人审图,而不是自动 Agent 拓扑课。
7. Claude Artifacts、Custom GPT,与 Cursor「vibe coding」
Artifacts:在对话里直接生成可在浏览器跑的小应用(闪卡、Mermaid 概念图等)——适合教学与可视化草稿。Memory / Custom instructions / Custom GPTs:把反复要讲的人设、格式、few-shot 例子固化成可复用助手;口播类比「教人做事:口头规则不如带例子」。
专业写代码时,他转向 Cursor 这类带仓库上下文的 IDE 助手(片中点到 Claude 等模型):不是网页里贴片段,而是让模型看见文件系统;Composer 一类能力开始接近「代写多文件改动」的代理感。他用 vibe coding 形容:人给方向,模型填大量样板与低层细节——爽的同时,仍然需要你对架构与边界负责。
解读:这是本片与帖文钩子唯一有「擦边」的地方——产品形态确实在从「对话框」走向「带工具循环的助手」。但 Karpathy 演示的是现成产品里的循环(搜索、解释器、Composer),不是教你用 LangGraph 画「谁规划、谁写、谁复核」的过夜 Graph。把后者硬安在本片标题上,是把 LunarResearcher 长文与另一套 X 营销模板,贴到了错误的视频上。
怎么看这条帖
- 正片价值:目前仍是中文读者最值得看的「LLM 产品用法总览」之一;官方 YouTube 可回源,章节清晰,适合收藏当目录页。
- 帖文水分:「Prompts → Agents → Loops → Graphs」「Harness 才是杠杆」「模型消耗品 / 系统护城河」等金句不是本片大纲;它们更像通用 Agent 工程文案,再叠到 Karpathy 高流量名字上。同源营销句曾套在站内另一篇 Software 3.0 斯坦福演讲 上——讲者同为 Karpathy,视频不是同一场(时长约 68.5 分 vs 本片约 2h;本场是桌面录屏实用向,那场是现场 keynote 讲范式与 Transformer 图)。
- 与 quote 长文的关系:LunarResearcher《Harness Engineering…》可以单独当选题;不要默认观众看完本视频就等于读过那篇指南。
- 镜像差异:本 X 文件约 7427 秒,官方约 7912 秒;抽样转写显示内容落在 How I use LLMs 中后段主题上,建议重要引用以官方片为准。
原文
- X 帖(含本镜像视频):https://x.com/huxlab/status/2115645934113800640
- 视频转载源:@0xkichiro
- 官方讲座:Andrej Karpathy — How I use LLMs