解读:Google Cloud Annie Wang 的 Agent 课——记忆、定时唤醒、杀进程还能 resume
本文是对 Google Cloud 工程师 Qingyue(Annie)Wang 一场约 2 小时 26 分钟 Agent 系列课的摘要与评论。推广帖来自 @0xShoopy(读帖时约 7205 曝光、71 收藏、99 赞);同帖还 quote 了她自己的 X Article《Graph Engineering: how to build the agent system that replaced loops》。本文只解读帖上挂载的这段课程视频。插图为演讲关键帧;完整内容请看原视频。配套官方 Codelab 署名亦为 Qingyue(Annie) Wang(见文末链接)。
后文实验都跑在 Google 的 ADK(Agent Development Kit) 上。可以把它理解成「做 agent 的开发套件」:提供会话、工具调用、工作流图、执行引擎等,而不是让你从零手写每一层。
全文主线可以压成一句:大模型只会在「被调用的这一轮」里思考和回答;跨时间、跨重启、跨用户的能力,都不在模型本身,而在模型外面的那层软件。 这堂课反复在证明这句话。
这篇在说什么
这堂课不是「再讲一遍怎么写 prompt」,而是讲模型外面那一层软件要管什么:上下文与记忆放在哪里、工具与工作流怎么接、定时唤醒为什么不能写在指令里、进程被杀后如何继续跑,以及付费类副作用怎样避免重复扣费。视频大致拼了三段:开头约 9 分钟讲 AI harness(agent 周围那整层软件),中段是山谷客服塔 Agent Valley / The Archive 的记忆实验,后段是假想购票站 MonsterTix 的长跑实验。
1. Agent harness 基础:模型懂,不等于能干活
开场有个 vignette(小场景):你让 coding agent「加一个导出 CSV 的按钮」。模型可能知道怎么写代码,但没有项目文件权限,也不会自己跑测试。中间还缺一层软件:把仓库上下文塞给它、把工具接上、授予执行权限,并管理模型和环境之间的多轮来回。她把这层叫 AI harness——字面是「马具」,这里就是套在模型外面、让 agent 真能干活的那套软件。
她把 harness 设计拆成四块,每块对应一类真实问题。
第一块是 Context & memory(上下文与记忆)。要解决的是:这一通对话记在哪、草稿状态放哪、跨会话还要不要记得这个人。它通常分成 session(整段对话加上工具调用记录)、state(一份键值草稿本),以及蒸馏后的长期事实。
第二块是 Tools & execution flow(工具与执行流)。要解决的是:模型怎么真正调用外部能力。本地函数、HTTP API,以及 MCP(一种让模型按统一协议去调用外部工具或数据源的接法)都可以挂在这里。ADK 的 graph workflow 还可以事先定义节点顺序、并行检查和重试上限,而不是每次全靠模型临场发挥。
第三块是 Runtime / security / privacy(运行时、安全与隐私)。要解决的是:代码在哪跑、凭证会不会泄漏、恶意指令会不会被当成系统命令。包括沙箱、把仓库里的可疑文字当不可信数据(prompt injection)、网络边界,以及敏感动作先暂停等人确认。还要问清楚:工具返回的内容会不会进模型上下文、进 session、进日志、进长期记忆。
第四块是 Agent evaluation(怎么验收)。要解决的是:怎么知道 agent 真做成了,而不只是「看起来会说」。可以做确定性检查(比如导出是否含那 10 个客户)、用另一个模型当裁判(LLM-as-judge),或让真人走查;这几类可以混用。
解读:把「agent」和「harness」拆开,是后半场记忆、定时唤醒、崩溃恢复、幂等能落地的前提。那些能力几乎都不在单次模型调用里。
四块里最先被展开、也最容易踩坑的,是第一块里的记忆:上下文放哪、跨会话怎么续、写进去了下次能不能找回来。下面就顺着这条线,进入山谷客服塔的实验。
2. 四类 agent memory:先讲清山谷里发生了什么
中段实验的故事背景叫 Agent Valley,核心场景是档案塔 The Archive。可以把它想成山谷里的客服中心:前台档案员叫 Vesper;访客夜里灯笼灭了(事情没办完),白天带着 case 号(工单号)回来。现实里最常见的痛点是:回访时客服「不认人」——上一通说过的偏好、进度、承诺,这一通全没了。实验要练的,就是让 agent 在「这一通 / 这个访客 / 整个山谷」三个尺度上都能接得上。
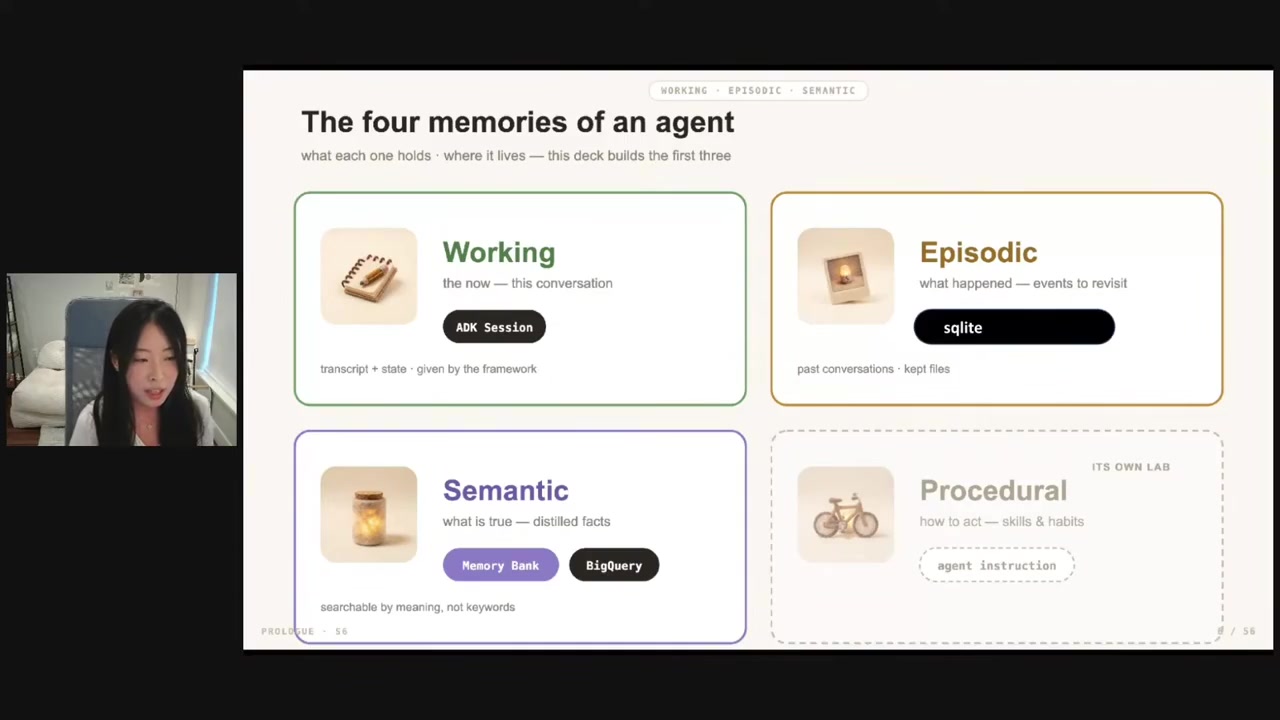
约 12:16,幻灯把 agent 的记忆画成四格。本次实验主要练前三类;第四类只带过。
| 类型 | 装什么 | 大致活多久 | 片中落点 |
|---|---|---|---|
| Working | 当前对话的「现在」 | 这一通 visit | ADK Session(对话记录 + state) |
| Episodic | 过去发生过什么 | 可跨多次 visit | Sqlite 等 session 持久化 |
| Semantic | 蒸馏后的「什么是真的」 | 长期、可改写 | Memory Bank、BigQuery |
| Procedural | 怎么做(技能与习惯) | 随 instruction 变 | agent instruction(本课标成另开一门,不练) |
对应到 Archive 故事:Working 是记得这一通对话;Episodic 是记得这个访客以前来过、上次 case 说到哪;Semantic 是能搜整个山谷里别人有没有同类问题(机构知识)。Procedural 更像「办事流程写进说明书」,本片不展开。
要把这些真正写进系统,口播和 Codelab 反复强调一句:state 是代码写进去的,不是聊出来的。 Codelab 的 EDIT ONE 就是改工具函数:若不显式写 tool_context.state[...] = ...,模型可以「听得很清楚」,session 里的 state 仍是空的。聊天记录在,不等于草稿本有值。
幻灯上还有两句金句,意思很近。A record is not a memory:存档不等于记住——文件躺在库里,不等于下次对话会去用。filed is not remembered:上架了不等于下次会去拿。后面 InMemoryMemoryService 那段,就是在演示「归档」和「召回」是两件独立的事。
state 要落盘,就得选 session 存在哪。ADK 的 Session service 常见有三条路。默认 InMemory:全在进程内存里,快,但重启就没了,适合她点名的语音等短会话。本 lab 用 Database / SqliteSessionService:写进本地库,进程挂了还能读回来。还有 Vertex AI 托管:交给云上会话服务。选哪条,取决于你能不能接受「一重启就失忆」。
ADK 还用键名前缀区分寿命,可以对照「活多久」来记:无前缀大致只活在本 visit;user: 跟着这个访客跨多次 session;app: 是全应用共享;temp: 是本轮临时,resume 时长跑时常常会丢,不能当检查点。
有了 session,还要能「归档后再找回来」。再往上是 InMemoryMemoryService:用 add_events_to_memory 把事件归档,用 search_memory 去召回。但默认实现是把整段事件原样塞进进程内字典,再按词频或关键词找;关进程就没了。所以「filed」只完成了上架;没有人调用搜索,或进程已经没了,都不算「remembered」。
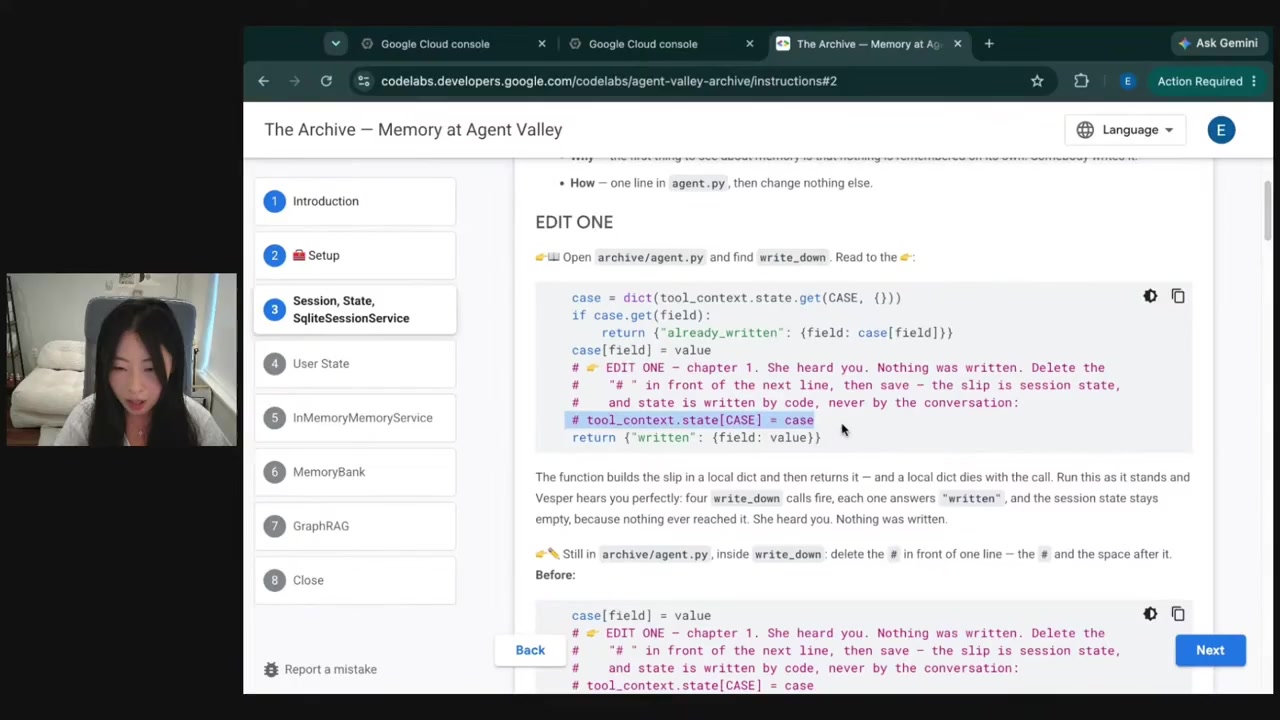
解读:前缀怎么切,以及「写策略和读策略拆开」,比「再加一个向量数据库」更先该钉死。很多「agent 失忆」其实是 state 没写,或写了却没人调用 search_memory。
上面这套进程内方案够演示,但有几处明显不够:不会从对话里蒸馏事实、偏好改了不会合并成当前真相、检索靠词频不靠语义、一关进程就清空。接下来她切到托管服务 Memory Bank,专门补这几块。
3. Memory Bank 与 GraphRAG:个人事实 vs 山谷知识
约 50:52 切入 Memory Bank。它是跑在 Vertex AI Agent Engine(Google 云上托管 agent 运行时)上的托管记忆服务。相对刚才的 InMemoryMemoryService,目标是:agent 业务代码几乎不用改,就能换上更强的记忆后端。
可以把它理解成几组对照。写入时不再塞整段聊天原文,而是用模型蒸馏事实(例如「访客偏好蓝色座位」);还可用 allowed_topics 在写入时裁掉「午饭吃了什么」这类不该进长期记忆的内容。偏好会变:今天喜欢紫色、明天改蓝色,系统会 consolidate(合并)成当前事实,而不是无限追加互相打架的旧句。读取时走 embedding,按语义检索,不是数共现词。存储挂在 Agent Engine 上,能活过本机进程重启;控制台可审计,并按用户隔离。遗忘方面,Codelab 强调 ADK 的 memory 抽象没有 delete:agent 不能随口说「忘掉吧」就生效;真正删除是应用侧治理(例如调用 memories.delete)。
到这里还缺一块:Memory Bank 按用户隔离,管的是「关于你」的个人事实。山谷仓库里还有别人的案例、机构知识,不能硬塞进同一作用域,否则隐私和检索范围都会乱。所以她接着讲 GraphRAG(用向量检索找入口,再用知识图做关联遍历的一种检索法):山谷数据放在 BigQuery(Google 的大数据仓库)里,原地跑 ML.GENERATE_EMBEDDING(片中与 Codelab 用 gemini-embedding-001),做「听起来像」的检索;再在 property graph 上 MATCH,做「连在一起」的遍历。向量负责找入口,图负责给引用路径。她反复强调:similar ≠ connected——语义相近,不等于图上真有边连着。
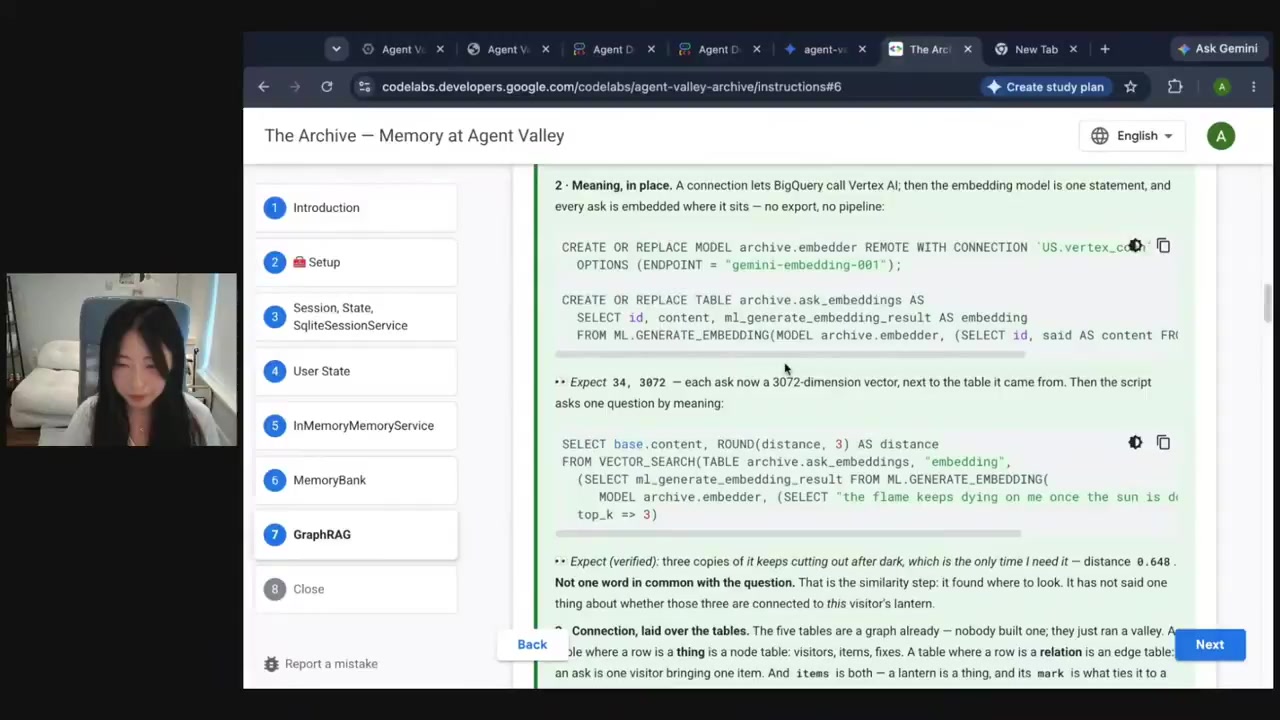
解读:Memory Bank 卖的不是「又一个向量库」,而是把写、合、读策略外置成服务,agent 代码几乎不动就能换存储。GraphRAG 那段则提醒:跨用户的机构记忆不该硬塞进「关于你」的 Memory Bank。
前半场把「记得住、找得回」讲清楚了。后半场换场景:假想购票站。问题不再是记没记住,而是「说好过一会儿再查」为什么根本跑不起来,以及进程挂了怎么接着干、重试时会不会扣两次钱。
4. 「10 秒后再查」为何没用:先讲清 MonsterTix
约 1:23:05 进入 MonsterTix:一个教学用的假想购票站,演唱会叫 Midnight Signal,队列极长。片中也声明:这是假场馆,不是教你去真实票务站刷票。
你自然会希望 agent 说「我 10 秒后再查一次排队进度」。它也会很有礼貌地答应——但不会真的设定时器。幻灯标题直接写:A prompt cannot schedule a run(一条提示词没法预约下一次运行)。原因回到开篇主线:instruction(系统指令)只在已经有人、或已经有外部事件调用这一轮时被读到;模型不会在后台自己醒过来。下一轮必须由外部事件启动。
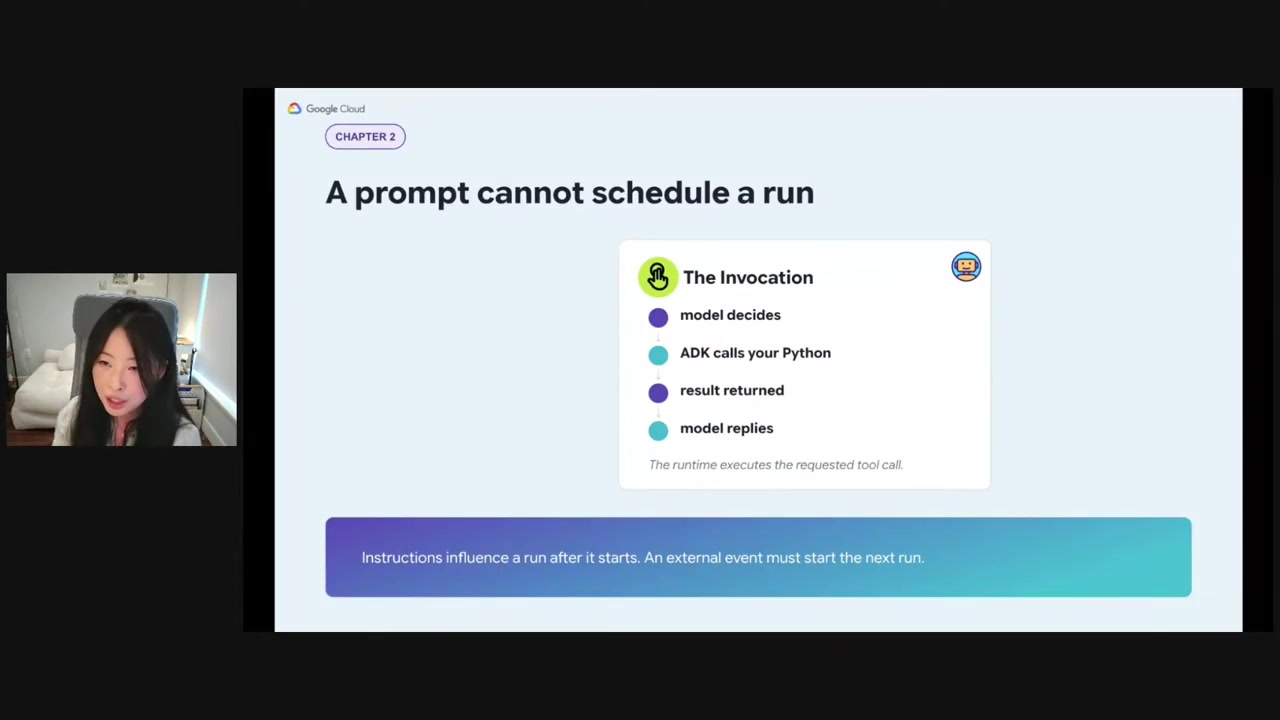
修法可以按三步搭骨架。
第一步,你的应用暴露一个 /wake(或同类)HTTP 端点,里面去调 ADK 的 Runner。Runner 是真正「跑一轮 agent」的执行引擎;Agent 对象本身更像一份描述(用什么模型、哪些工具、什么指令),不会自己定时苏醒。第二步,外部的 clock、cron、Pub/Sub 或页面按钮 在到期时向这个端点 POST 一次。第三步,Runner 绑定之前的 session 与 memory,再跑一轮工具(查队列、座位图等)。
Lab 里拆成三步:2a Prompt(先亲眼看到「只写指令不够」)、2b Server(起服务监听 wake)、2c Clock(用时钟发下一次请求)。口播也澄清:Runner 不等于 harness;harness 是 agent 周围整层,Runner 是其中负责执行的那一块。
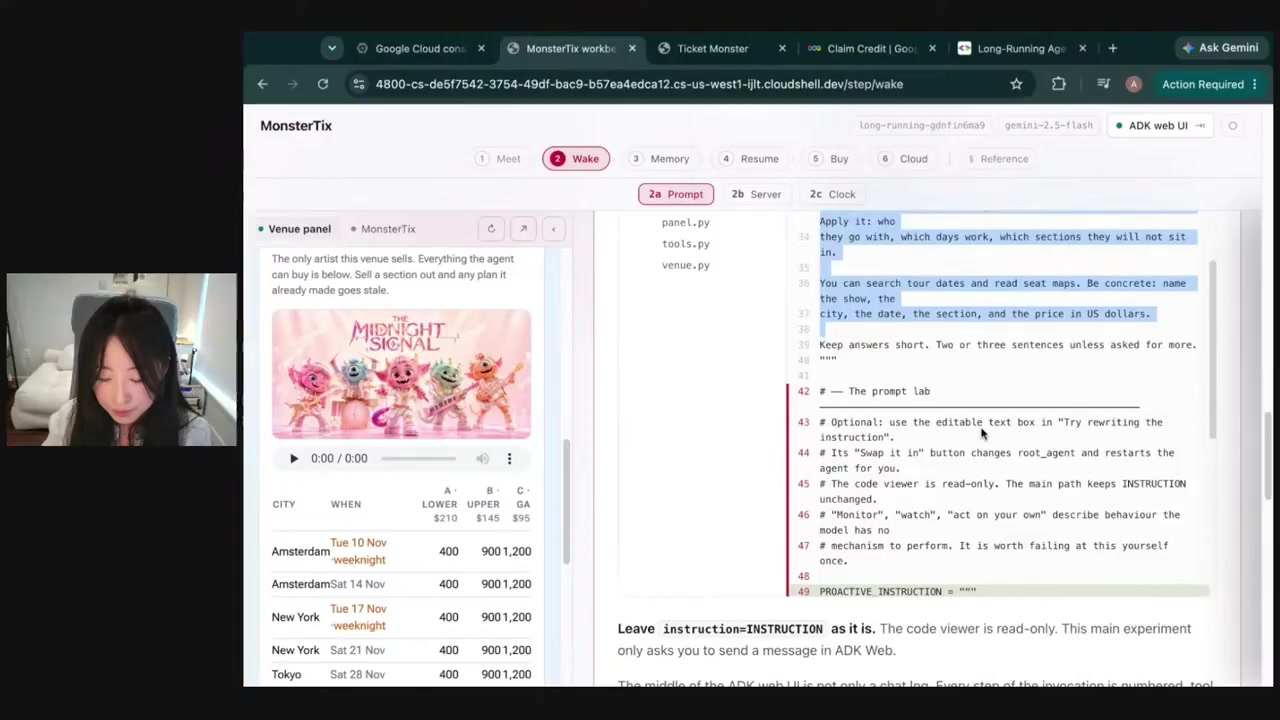
解读:这是生产里最常踩的坑之一:把「以后再做」写进 system prompt。模型只能在被调用时表现得像会等到;真正的 sleep 与 wake 属于基础设施。
wake 解决的是「到点再跑一轮」。那如果跑到一半进程被干掉呢?下一节用 kill -9 测的,正是 session 持久化加上再次触发,能不能把任务捡回来。
5. 中途 kill 后如何 resume
约 2:00:26,时间线是这样的:购票队列还在走,演示者对 ADK web 进程执行 kill -9(强制杀死进程)。场馆侧仍占着你的号;session 库里仍有 saved task(已保存的任务检查点)。只把进程重新拉起来,不会自动接着跑——还要显式 resume,或再发一次 wake,让 Runner 重新接手。演示强调:把 session 与 state 持久化下来,是长跑任务和 human-in-the-loop(例如预算确认等人点头)的地基。也要注意:标成 temp: 的临时状态,resume 时往往会丢,不能指望它当检查点。
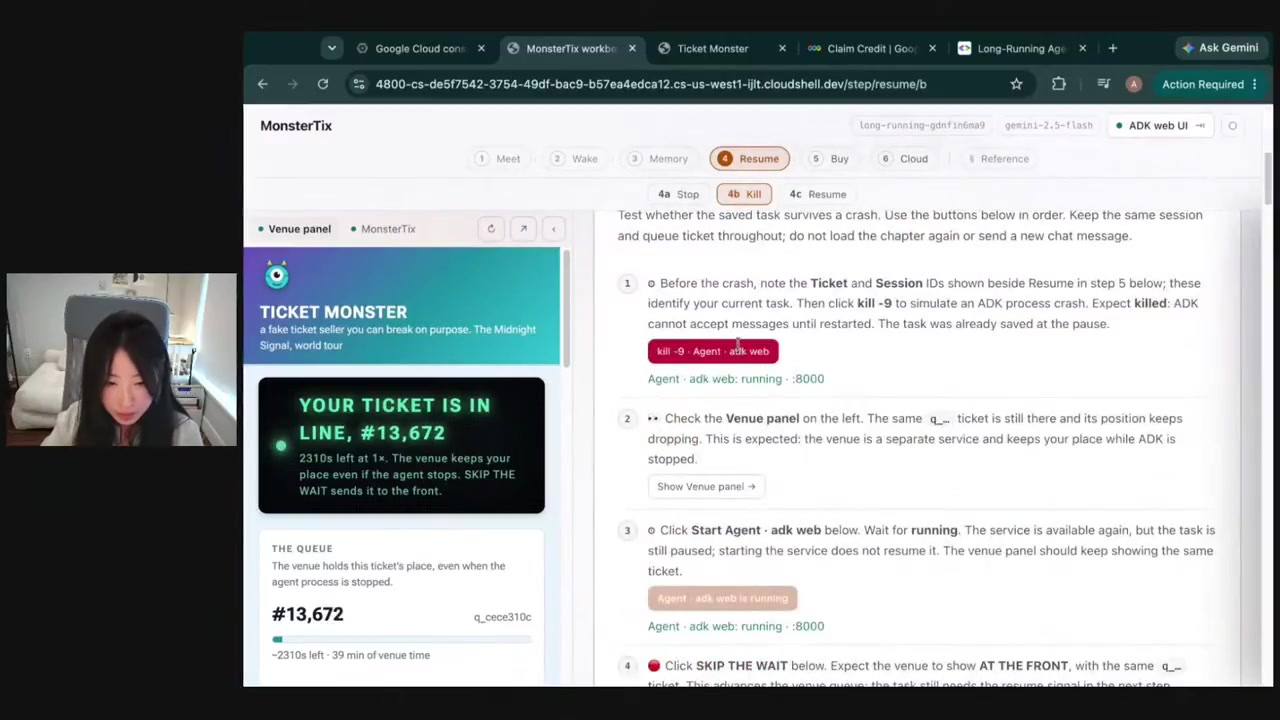
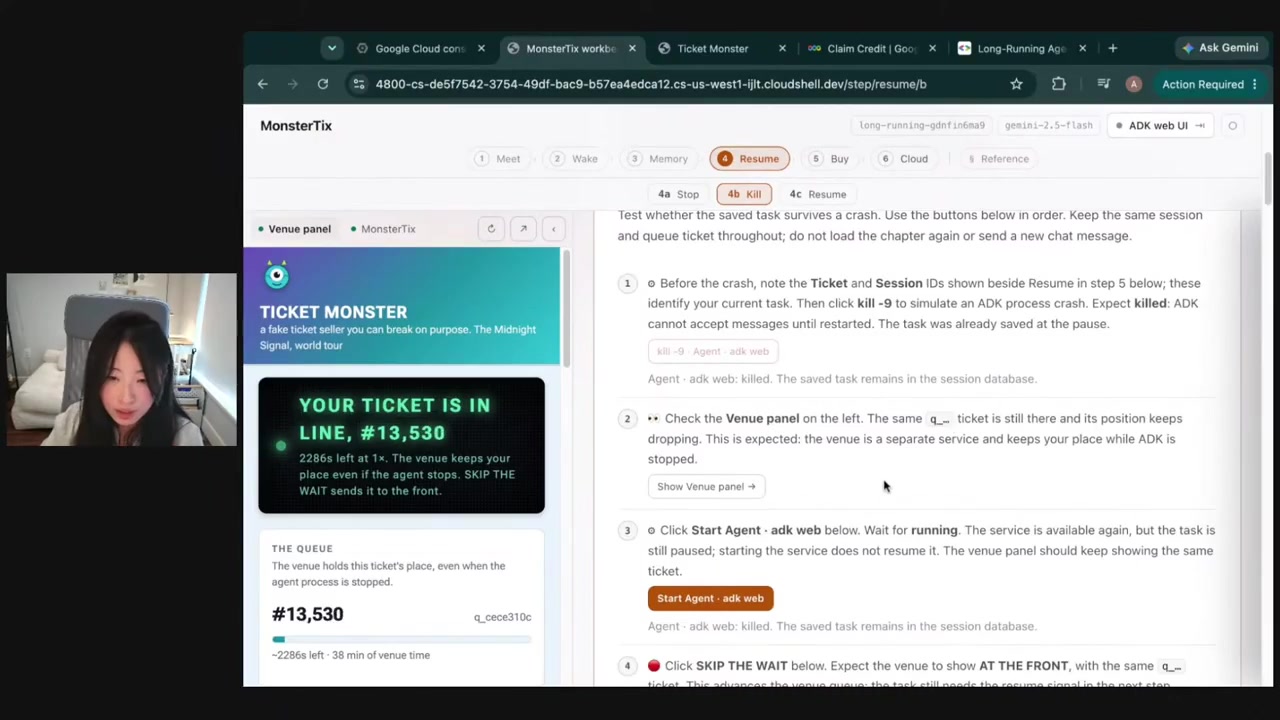
解读:resume 不是「聊天记录还在」这么简单,而是任务检查点加上外部触发器两件套。杀进程测的是 harness 的持久化,不是模型记性好不好。
长跑一旦会重试、会 resume,下一个坑就来了:同一笔购票若因网络抖动被提交两次,就会重复扣费。所以片尾专门讲幂等护栏。
6. 防重复收费:idempotency key 白话
约 2:20:04:购票工具已经在场馆侧提交了订单,但接口返回 HTTP 503(服务暂时不可用)。如果客户端看见失败就盲目再发一次,场馆可能扣两次钱。幻灯里的做法是:工具带上同一把 idempotency key(幂等键,片中记作 K1) 和同一份请求内容,自动再试一次;场馆认出「这把钥匙对应的订单 O1 已经存在」,只确认一笔,不新开第二单。白话说:同一把钥匙加上同一份请求,对方只认一笔账。 另外还有座位过期类 staleness guard(过期护栏)或 callback,避免按已经过时的座位图下单。
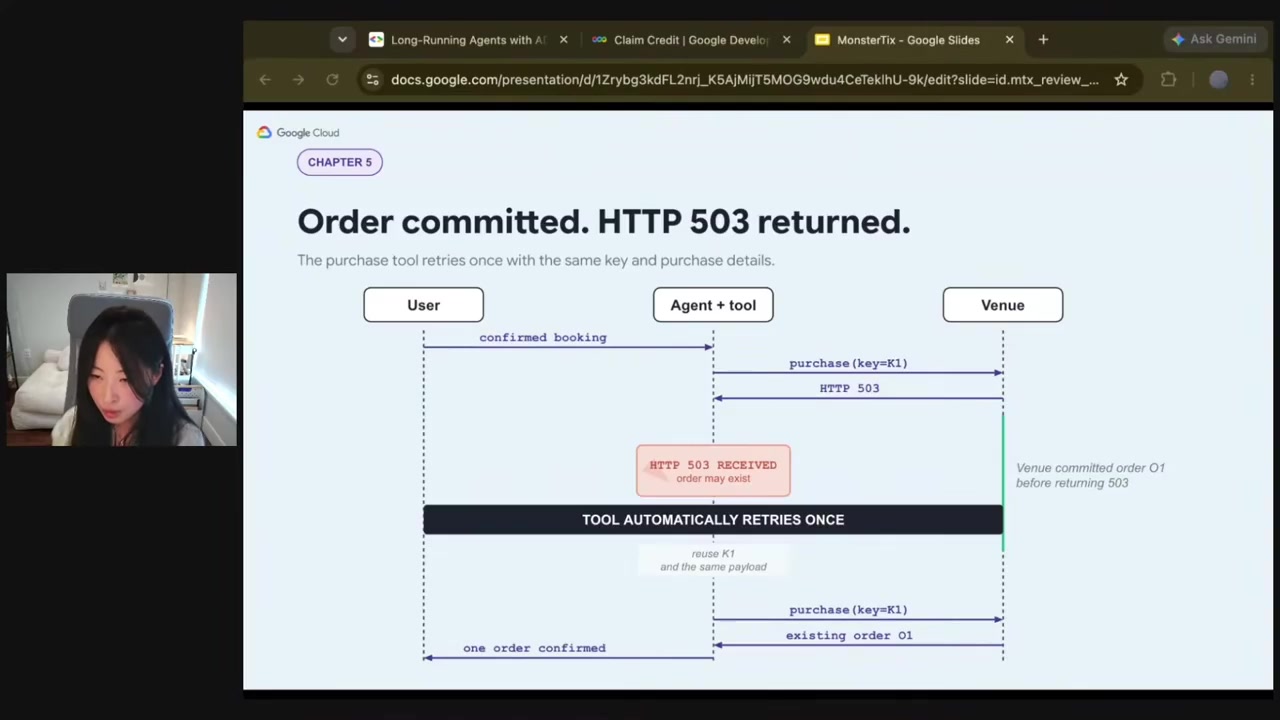
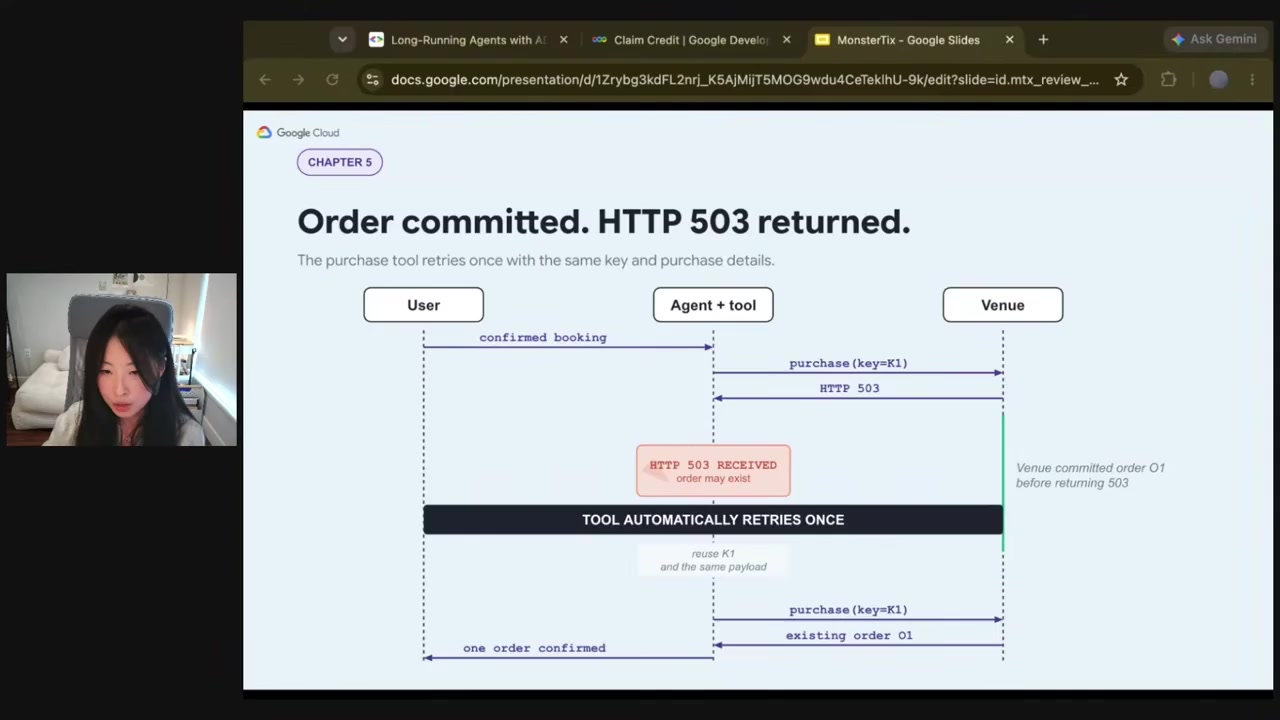
解读:agent 一接上「会花钱的工具」,可靠性问题立刻变成分布式系统的老问题:幂等键、过期校验、需要人确认的预算。这些和「模型聪不聪明」是正交的。再次强调:MonsterTix 是教学用假场馆。
怎么看这条内容
第一,值什么。它把记忆、定时、崩溃恢复、花钱四类生产问题,拆成可替换的服务边界(session、state、Memory Bank、wake、idempotency),比「免费 2.5 小时 agent 课」的营销句更耐用。
第二,要打折什么。帖文时间戳与口播大体吻合,但视频是多段 workshop 拼接(harness 短片、Archive、MonsterTix),不是单一「一门课从头讲到尾」的剪辑节奏。中段有现场问答,demo 偶发卡顿,信息密度不如幻灯页。
第三,别和同帖 quote 搅在一起。《Graph Engineering…》 是另一套「用图工程替换循环」叙事;本片主线是 ADK harness、记忆分层、长跑触发与幂等。
第四,讲者依据。片中 Google Cloud 幻灯与 Codelab 页脚可对上;官方 Codelab The Archive — Memory at Agent Valley 与相关 ADK 材料署名 Qingyue(Annie) Wang;另有同系列 Medium / YouTube「AI harness」短片可对照。
可继续阅读原文与完整演示:
- X 原帖与视频(@0xShoopy)
- 官方 Codelab:The Archive — Memory at Agent Valley(记忆分层)
- 官方 Codelab:MonsterTix — Long-Running Agents(wake / resume / 幂等)
- 同系列短片:AI harness crash course(YouTube)
- 同帖 quote(另文,非本片):Graph Engineering…(@0xShoopy)
截图仅作解读插图,版权与表述以原演讲为准;本文不做逐字稿转载。专有名词以幻灯与 Codelab 为准。