解读:Microsoft BitNet——1-bit LLM 的官方推理框架 bitnet.cpp
本文是对开源项目 microsoft/BitNet 的摘要与评论。抓取时仓库约 ★41238、forks≈3837、open issues≈375;语言 C++,许可证 MIT;默认分支 main(创建于 2024-08-05,页面更新至约 2026-10-27)。产品主名是 bitnet.cpp:面向 1-bit / BitNet b1.58 一类模型的官方推理框架。插图为 GitHub 社交预览图;完整安装、内核与模型表请看仓库 README。
说明:下文数字(加速比、能耗降幅、可跑规模)均转述自官方 README / 技术报告表述,并非本站实测。选型前请以仓库与论文为准。
全文主线可以压成一句:bitnet.cpp 是给「三值权重」专用的推理 runtime,不是把任意 Hugging Face 模型事后压成 1.58 bit 的魔法开关。
这篇在说什么
先讲清问题设定。本地跑大模型时,内存与功耗常常比「聪不聪明」更先卡死——笔记本 CPU、边缘设备、想压电费的人,都会问:能不能用更少比特存权重,还能保持可用速度?常见路径是把已训好的 fp16/bf16 模型事后量化到 Q4/Q5;另一条更激进的路,是训练阶段就把权重量化形态定死,再配专用 kernel(计算内核)。
BitNet 系列走的是后者。一句话理解本仓库:给你一套针对 三值权重(约 1.58 bit,即 {-1, 0, +1}) 的优化内核与工具链,在 CPU(及官方 GPU kernel) 上做尽量快、尽量「无损于该量化格式」的推理。
它和「把一个已训好的 fp16/bf16 模型事后压到 Q4/Q5」不是同一条路:
- BitNet b1.58:训练/设计阶段就把权重量化形态定成三值;推理侧再配专用 kernel。
- bitnet.cpp:是推理框架(基于 llama.cpp,kernel 思路与 T-MAC lookup table 相关),不是训练套件。想训自己的 1-bit 模型,要另找训练代码与配方(README 里链到 unilm/BitNet 相关 FAQ 与论文)。
先分清三条容易混在一起的线
读者新接触 BitNet 时,常把三件事揉成一团:研究论文里的训练方法、Hugging Face 上的权重文件、以及本仓库的 bitnet.cpp 推理框架。三条线相关,但不自动互通。论文告诉你三值权重为何可能又省又快;权重文件决定你到底有没有可跑的 1.58-bit 模型;bitnet.cpp 决定这些权重能否在目标 CPU/GPU 上吃到专用内核。
缺任何一条,都不会出现 README 加速表上的那种体验。把任意模型「事后压一压」就期望同等数字,是把三条线误读成了一条。下文按「推理框架 → 官方宣称收益 → 模型生态 → 怎么跑 → 与普通量化对照」展开,方便你按自己的库存对号入座。
解读:仓库名 BitNet、README 标题 bitnet.cpp——读的时候把「研究系列名」和「可跑的推理 runtime」分开记,少踩「clone 下来就能训练」的预期坑。
为什么值得看
官方 README 声称(相对全精度对照、以报告为准):
- ARM CPU:约 1.37×–5.07× 加速;能耗降约 55.4%–70.0%
- x86 CPU:约 2.37×–6.17× 加速;能耗降约 71.9%–82.2%
- 单 CPU 可跑约 100B 量级 BitNet b1.58,吞吐到「人读速度级」约 5–7 tok/s(官方表述)
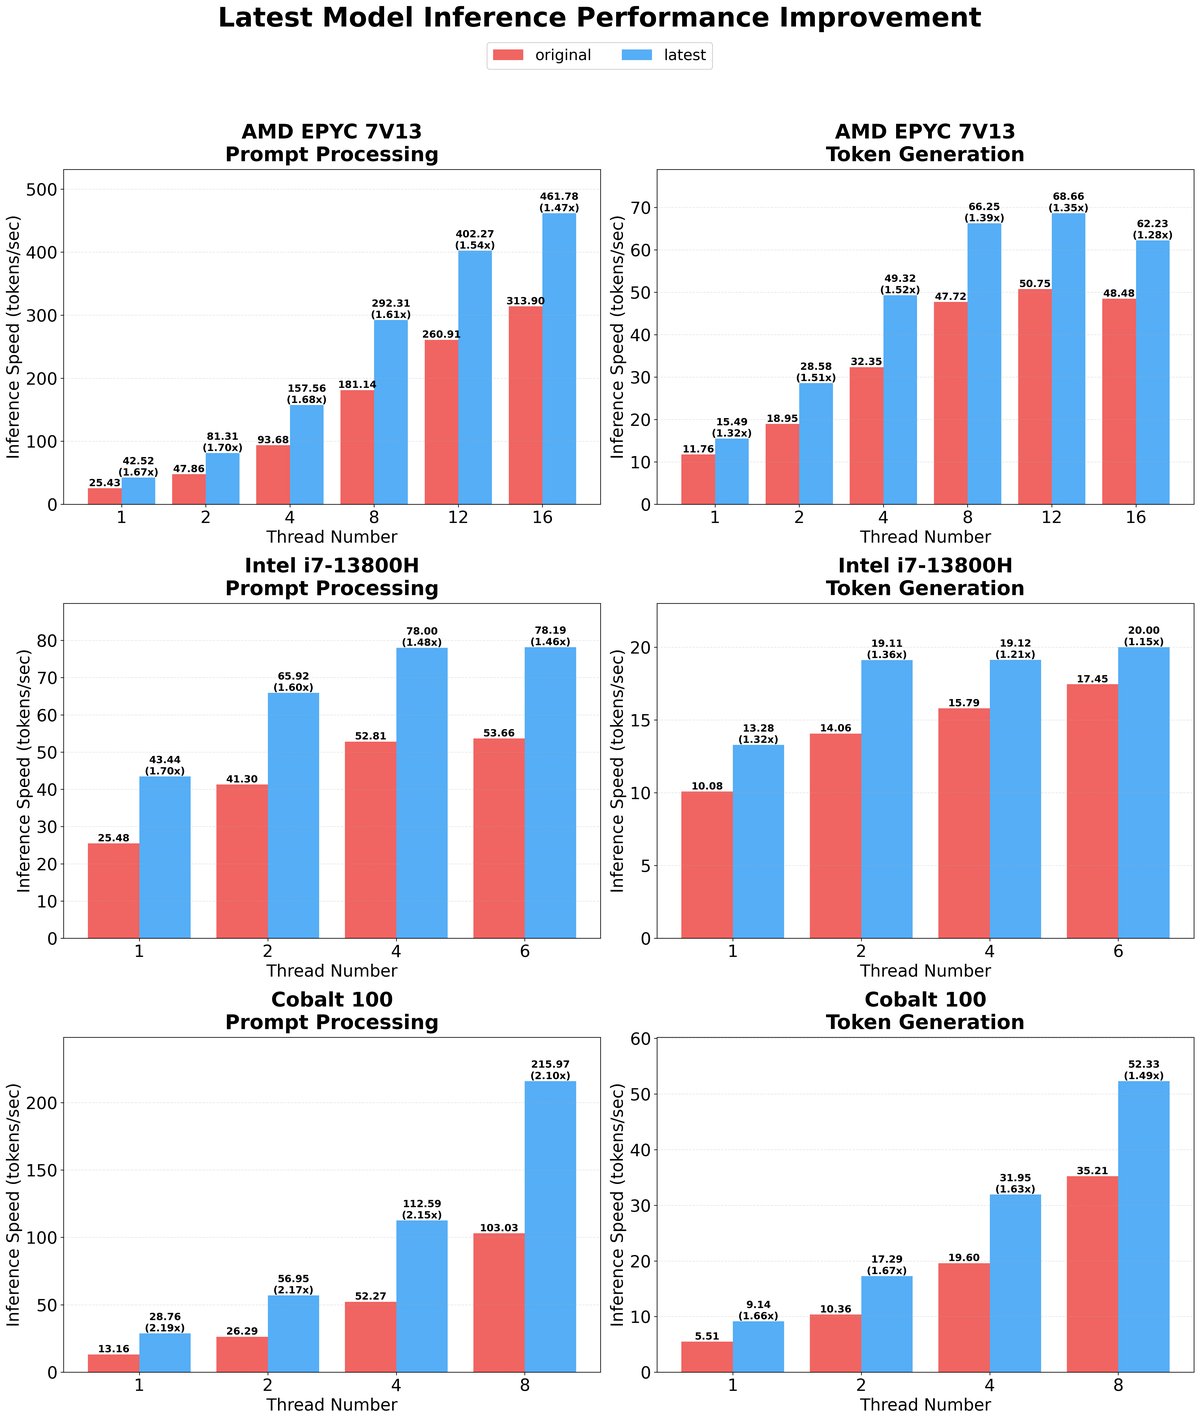
更细的系统与评测见技术报告 arXiv:2410.16144 与框架文 arXiv:2502.11880。仓库内 assets/performance.png 的对比图(本站转存为 JPG,来源为该 MIT 仓库):
边缘设备、本地 CPU 优先、想压内存与功耗时,这类「原生低比特 + 专用 kernel」比「通用量化格式硬跑」更像一条独立赛道。GPU 侧另有官方 gpu/README.md;在线可先试 Demo。
解读:加速与能耗数字是相对官方设定基线的宣传点,换硬件、线程数、模型体量都会变。把它当成「有潜力」信号即可,别当成你笔记本上的保证 SLA。
官方模型与生态
Hugging Face 合集:microsoft/bitnet。README 当前点名的官方线包括:
| 模型 | 体量要点 | 备注 |
|---|---|---|
| BitNet-b1.58-2B-4T | 约 2.4B 参数,4T tokens | 官方聊天向 1.58-bit LLM;有 GGUF 等推理产物 |
| BitNet-embedding-0.6B | 0.6B embedding | README 称相对 F16 prefill 约 1.42×–2.28×(8 threads 等条件) |
| BitNet-embedding-270M | 270M embedding | 更轻;README 称约 1.32×–1.74× |
社区侧 README 表里还有 bitnet_b1_58-large / 3B、Llama3-8B-1.58、Falcon3 / Falcon-E 等 已按 1.58-bit 路线发布 的权重,并标注 I2_S / TL1 / TL2 等 kernel 在 x86/ARM 上的支持矩阵——以仓库表格为准。
周边动态(择要,勿当完整 changelog):README 提到 VibeASR.cpp(BitNet I2_S 量化相关的 CPU 实时 ASR)、以及 embeddings 的 I2_S 转换指南等。说明「1-bit 栈」在往语音与向量检索侧延伸,而不只停在聊天 LLM。
解读:生态价值在「有原生权重 + 有匹配 runtime」。社区把别的架构「改造成 1.58」能不能用,取决于人家是否真按该配方训/转,而不是 HF 上随便一个 GGUF 换后缀。
怎么跑起来(极简)
依赖(README):Python ≥ 3.10、CMake ≥ 3.22、Clang ≥ 18(Windows 需按文档用 VS2022 Developer 环境)。推荐 conda。
git clone --recursive https://github.com/microsoft/BitNet.git
cd BitNet

# 建议新建环境后
pip install -r requirements.txt

# 示例:拉官方 2B GGUF 并按 i2_s 准备
huggingface-cli download microsoft/BitNet-b1.58-2B-4T-gguf \
  --local-dir models/BitNet-b1.58-2B-4T
python setup_env.py -md models/BitNet-b1.58-2B-4T -q i2_s

# 推理(对话模式示例)
python run_inference.py \
  -m models/BitNet-b1.58-2B-4T/ggml-model-i2_s.gguf \
  -p "You are a helpful assistant" -cnv
setup_env.py / run_inference.py 还有 HF repo 快捷参数、线程数、温度等;完整 help 以仓库为准,这里不贴长 usage。从 safetensors 转 GGUF 可用仓库 utils/convert-helper-bitnet.py。
解读:门槛主要在 编译工具链(Clang 版本) 和 模型目录是否对上 quant 类型,不在 Python 脚本本身。第一次失败优先查 FAQ(README 底部 cmake / Windows clang 环境一类问题)。
和 llama.cpp / 普通量化的关系
bitnet.cpp 基于 llama.cpp,但卖点不是「又一个通用后端」,而是给三值/1-bit 布局做了专用 kernel;README 也写明:一般低比特(非 ternary)推理更建议看 T-MAC。
对照记忆:
| 普通 llama.cpp 量化(Q4 等) | bitnet.cpp | |
|---|---|---|
| 权重从哪来 | 多为已训全精度/BF16 再量化 | 期望原生 BitNet / 1.58 系权重 |
| 目标 | 通用模型兼容面宽 | 1-bit/ternary 上更快更省 |
| 「无损」含义 | 相对原精度通常有损 | README 强调对该 1.58 表示的高效、格式意义下的 lossless inference |
解读:如果你的库存全是 Llama/Qwen 的 Q4_K GGUF,直接换 bitnet.cpp 不会魔法变快;要对齐的是权重形态 + kernel,不是「安装另一个 cpp」。
什么人应该认真试,什么人看一眼就好
认真试的画像大致是:手上有(或愿意下载)官方/社区明确支持的 BitNet b1.58 权重;推理环境以 CPU 或官方 GPU kernel 为主;在意内存与功耗,而不是「随便哪个 GGUF 都能跑」。按 README 把 Clang、CMake、模型目录与 quant 类型对齐后,用官方 2B 聊天模型或 embedding 模型跑通一次,才能判断加速表是否在你的硬件上有意义。
看一眼就好的画像是:库存全是 Llama/Qwen/其他架构的 Q4/Q5 GGUF;主要诉求是兼容面与生态插件;没有意愿处理较新的 Clang 工具链。对你来说,继续用通用 llama.cpp / 厂商 runtime 通常更省事;需要更激进的低比特时,也可先看 T-MAC 等面向非 ternary 的路径。
还有一个预期管理:README 里的「lossless」是相对 1.58 表示本身 的高效推理表述,不是「和未量化原模型逐 token 一致」。论文与系统报告会继续更新激活位数、训练配方与内核——跟踪 HF collection 与仓库 News,比收藏一张加速截图有用。
解读:BitNet 栈是「权重形态 + runtime」绑定的赛道。把它误当成通用量化后端,是最常见的失望来源;对齐形态后再谈加速,才是公平比较。
若你只是想在笔记本上随便聊两句,官方 Demo 或现成聊天应用通常更省事;若你在做边缘部署、嵌入检索或 ASR 相关实验,并且已经接受 1.58-bit 权重形态,再为 bitnet.cpp 的编译与模型目录付学习成本,回报才更说得通。
Windows 用户尤须按文档准备 VS2022 Developer 与 Clang 环境,许多「配置看起来对、编译就是失败」的报告,根因都在工具链而不是模型文件本身。
在线 Demo 适合建立直觉;真要评估能否上边缘设备,仍需在你自己的 CPU 型号与线程数下复现 README 评测条件,而不是直接外推宣传区间。
论文条目以仓库与 arXiv 页面为准,本文只列入口、不代替精读。
怎么看
选型边界可以压成三句:
- 需要原生(或官方/社区明确支持的)BitNet b1.58 / 1-bit 权重;不是把任意 HF 模型「压成 1.58bit」就自动无损、自动吃满加速表。
- 场景偏本地 CPU / 边缘功耗与内存,或愿意跟官方 GPU kernel;要最大兼容面仍看通用 llama.cpp / 各厂商 runtime。
- 跟踪论文与合集:训练方法、激活位数(如 a4.8)、系统报告会继续动;以 README News 与 HF collection 为准。
完整参数、支持模型矩阵与构建问题以仓库为准。相关论文入口:BitNet 原论文 2310.11453、b1.58 2402.17764、CPU 推理报告 2410.16144、bitnet.cpp 系统文 2502.11880。