解读:斯坦福 CS329A「推理时算力缩放」——帖文金句与讲座内容不是一回事
本文是对 @lesliedqbb 挂载的一段约 63.4 分钟(duration_ms=3802569,1280×720)横屏视频的摘要与评论(读帖时约 937 曝光、11 赞、19 收藏、1 转发)。帖文中文钩子写「她 18 岁时用 Opus 5 构建 AI 代理,以 320 万美元卖给 Anthropic,再到斯坦福展示从零怎么做」,并点名「4 个代理取代了 400 名 Anthropic 工程师」「从第一个提示到 Anthropic 开出的 320 万美元支票」。
核对后:钩子与片中口播不符。 正片是斯坦福 CS329A Self-Improving AI Agents(Autumn 2025)第 2 讲 Test-Time Compute Scaling,主讲 Azalia Mirhoseini(Stanford CS 助理教授;与 Aakanksha Chowdhery 共同授课)。官方录像在 Stanford Online 频道:YouTube Part 2;课表见 cs329a.stanford.edu。公开侧(含 AI Hype Audit 对同账号同类模板的审计)亦指出:这类「卖掉 Agent / 取代几百工程师 / 斯坦福教你复制」是同一账号反复换买家与金额的营销模板,视频本身是学术讲座,不是成交公告。Anthropic 2026 年公开收购对象是公司主体,而非陌生人「一晚上做出来的 Agent」。
本稿依据 X 镜像视频关键帧 + 官方 YouTube 英文字幕整理,不是逐字转载。插图为片中关键帧。完整口播请看原帖视频或官方 Part 2。
这篇在说什么
一条主线:在不改模型参数、不做额外微调的前提下,把算力花在推理(inference / test-time)上,也能系统性地抬高能力——前提是你有办法挑出好答案(验证器、奖励模型、多数票、融合等)。
若你没听过这堂课,可以先抓住一个生活类比:同一道数学题,让学生答一次,和让学生答二十次再由老师批改选出对的那次,正确率可以差很多——前提是老师(验证器)真的会批改。课里把「答多次」叫做 test-time compute(推理时算力),把「老师批改」叫做 verifier(验证器)。帖文把它改写成「十八岁一晚卖掉 Agent」,等于把习题课改写成中奖新闻。
课表指定阅读大致对应片中四块:
| 论文 / 主题 | 片中重心 |
|---|---|
| Large Language Monkeys(Brown et al.) | 重复采样 + 验证器;coverage 随样本数呈可拟合的 power law |
| How Do Large Language Monkeys Get Their Power (Laws)? | 单题指数衰减 vs 题集 power law;长尾难题是必要条件 |
| Scaling LLM Test-Time Compute Optimally(Snell et al.) | 并行 best-of-N vs 序列修正;ORM / PRM;与预训练 FLOPs 对照 |
| Archon(Saad-Falcon et al.) | 把「推理时技巧」当成可搜索的架构,在预算下拼装采样 / 融合 / 批评 / 验证 / 单测生成 |
帖文时间戳(「00:34 Opus 5 建 320 万 Agent」等)与片中章节对不上,解读时请直接忽略。
1. 新前沿在 Inference,不在「再训一个更大的基座」
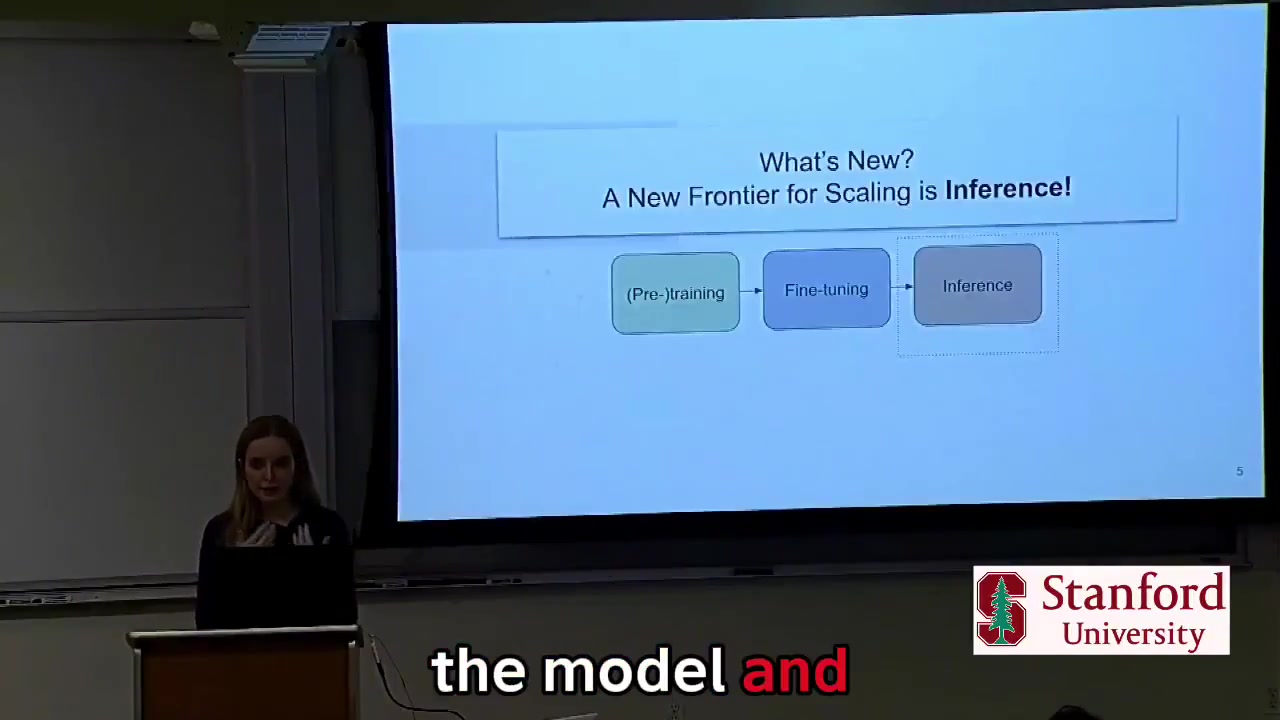
开场把 LLM 生命周期画成三格:Pre-training → Fine-tuning → Inference,并强调第三格是新的缩放轴:预训练仍可能烧数月 GPU,微调数据量通常小几个数量级;而推理侧可以反复问同一题、离线堆 token,在不更新权重的情况下抬高可用能力。口播点到:过去公司把大钱砸在预训练,每次用户调用几乎「一次来回」;现在可以把大量算力留给推理,甚至让 Agent 在后台持续生成再筛选。
解读:这对工程读者的可执行启发不是「别预训练了」,而是:能力预算里要单独留一栏给 test-time——采样次数、修正轮数、验证成本,都要进报价与 SLA。
换句话说:上线报价单里如果只有「用哪个基座模型」,却没有「每题最多采几次、验证失败如何重试、验证本身要花多少钱」,你还在用「一次来回」的旧账本管新时代的推理账单。
2. Large Language Monkeys:重复采样 + 验证器
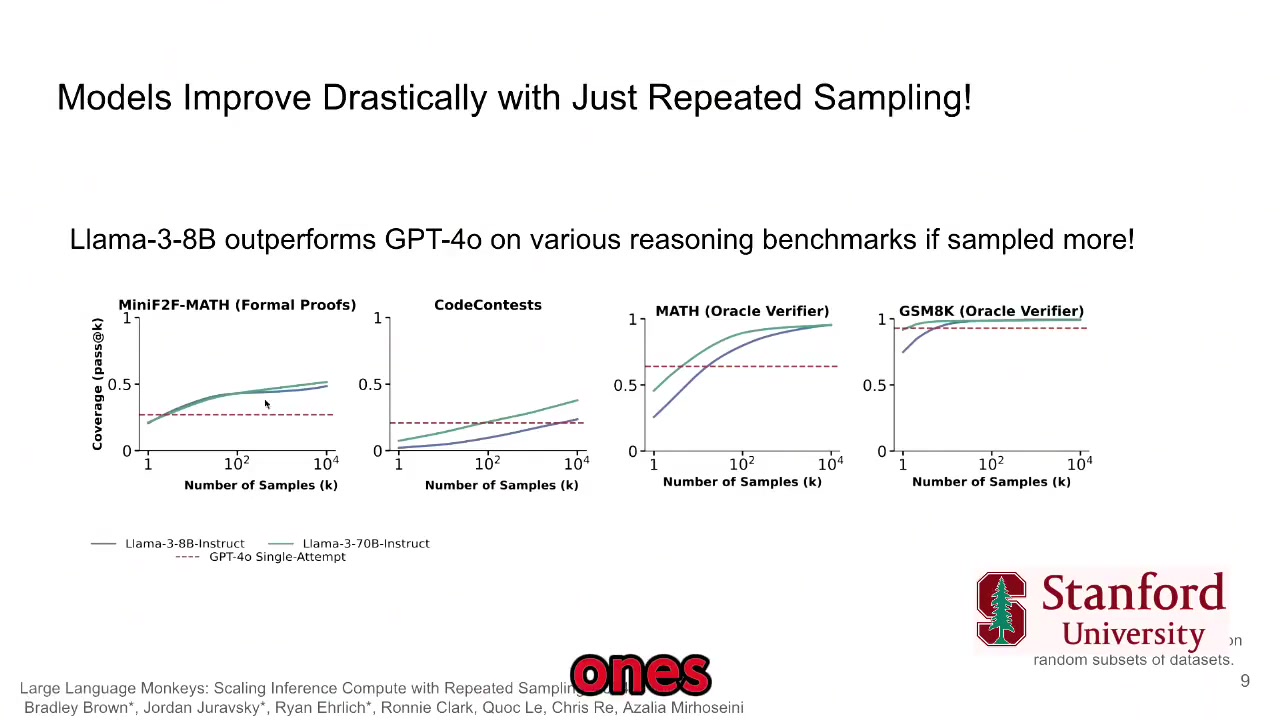
核心实验直觉:对同一输入采 k 次,用验证器挑对的那条。幻灯显示:在足够采样下,Llama-3-8B 一类开源模型在若干推理基准上的 coverage(至少一次采对的比例)可以超过 GPT-4o 单次。口播把现象说成:较小模型「其实有时已经知道答案」,只是第一次不一定说出来——重复采样是在把潜在解「捞」出来。
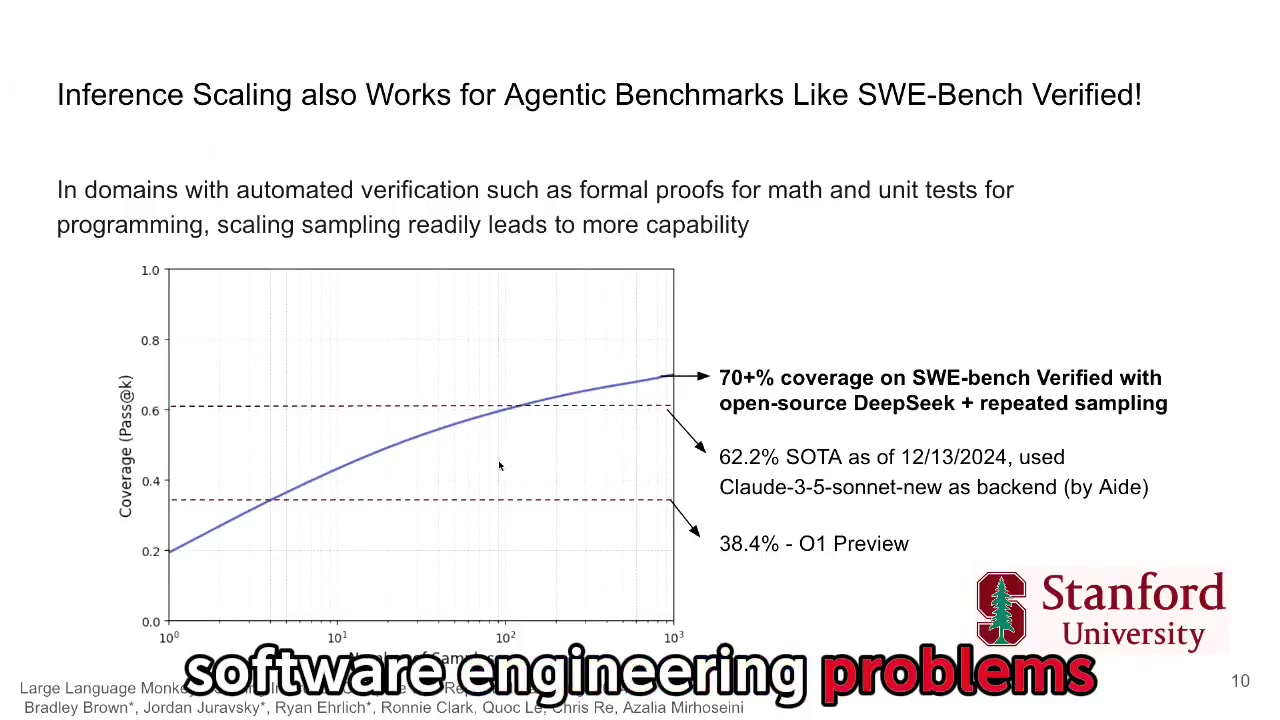
同一范式延伸到带自动验证的 Agent 基准(幻灯写 SWE-Bench Verified):在有单测 / 形式化证明可判定对错时,开源模型 + 大规模采样的 coverage 曲线可压过当时部分闭源 SOTA 单次结果。片中举例 DeepSeek 类模型在千级采样后覆盖率抬升。
随后讲 pass@k 的缩放律:题集层面 coverage 对 k 常呈可拟合的指数/幂律;单题层面更接近「至少一次对」的指数式。进一步追问「为什么题集是 power law」时,结论指向:题集里要有足够长尾难题,否则曲线形态对不上。
解读:没有验证器,重复采样只是堆候选;有验证器(单测、形式证明、输出一致性比对),它才变成「可自动变强」的流水线。帖文里的「一晚做出可卖千万的 Agent」把这套学术机制改写成了个人发财故事。
工程上落地时,先问域是否「可自动判对错」。有单测的代码修复、有标准答案的数学题、可用参考实现对照的内核生成,适合加采样;开放式文案、战略备忘、需要价值判断的决策,验证器本身就不可靠,best-of-N 会变成「堆一堆听起来像那么回事的段落」。课的锋利处在承认这条鸿沟,而不是假装处处能采样通关。
3. 验证鸿沟:有自动校验 vs 只能打分
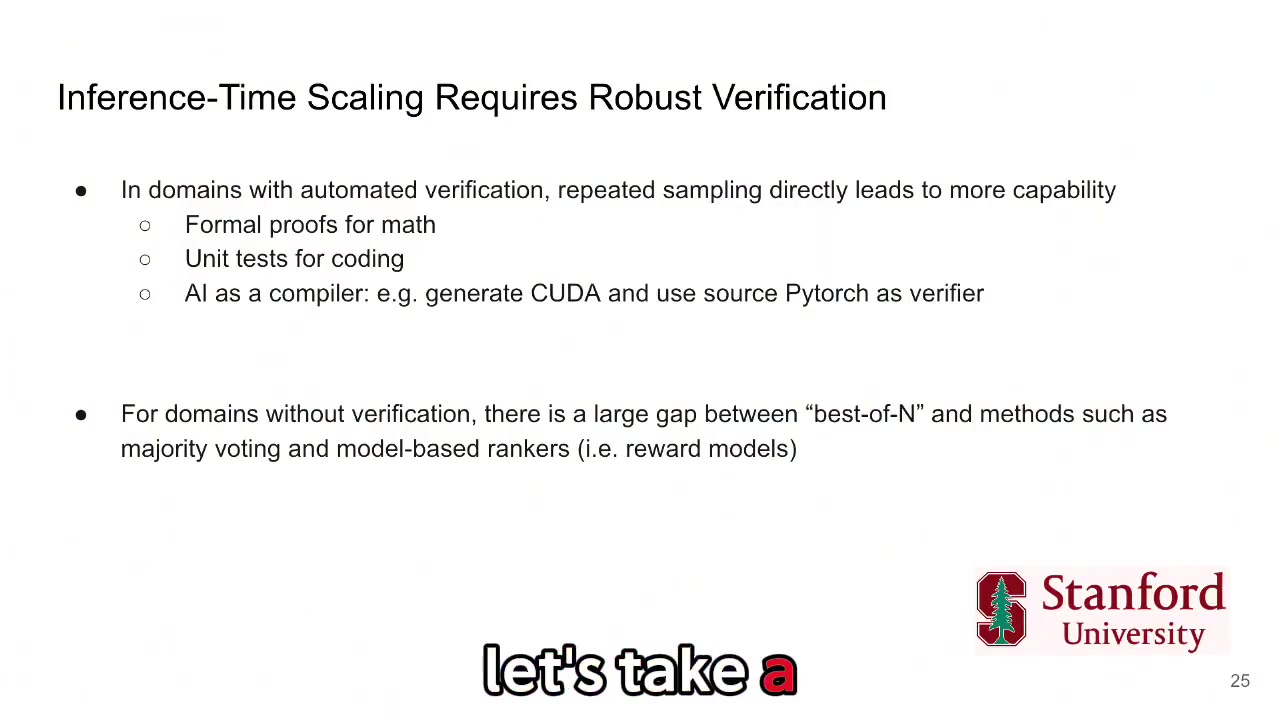
关键句:在可自动验证的域(形式化数学、代码单测、「AI as a compiler」——用源 PyTorch 行为当 CUDA 生成的校验器,并点到 KernelBench),加采样几乎直接换能力;在缺少硬校验的域,best-of-N 与多数票 / 奖励模型排序之间仍有大缝。
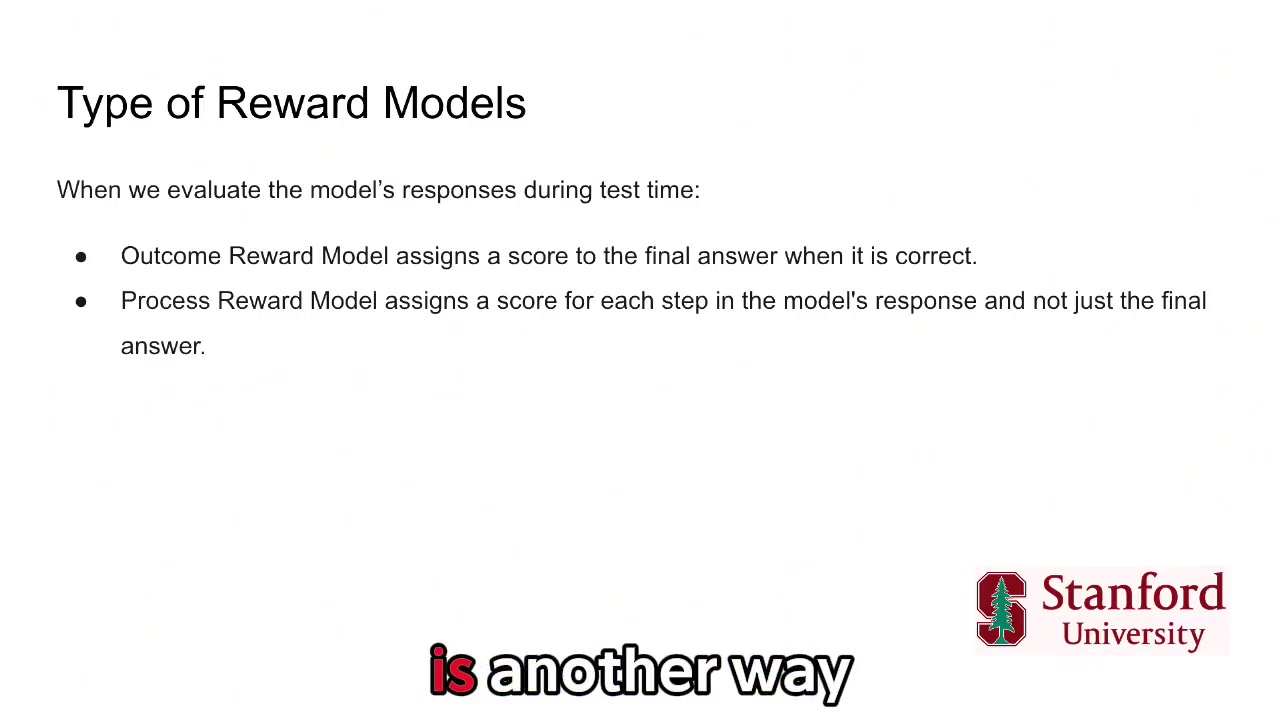
奖励模型两分法写得很干净:
- Outcome Reward Model(ORM):只给最终答案打分
- Process Reward Model(PRM):逐步打分,用于引导序列修正 / 搜索
口播还讨论并行采样与序列 revision 的组合,以及「按难度分箱后,简单题更偏序列、难题上最优配比更不稳定」——没有万能配方。
4. 与预训练对照:简单题可「推理硬刚」,最难题仍吃基座
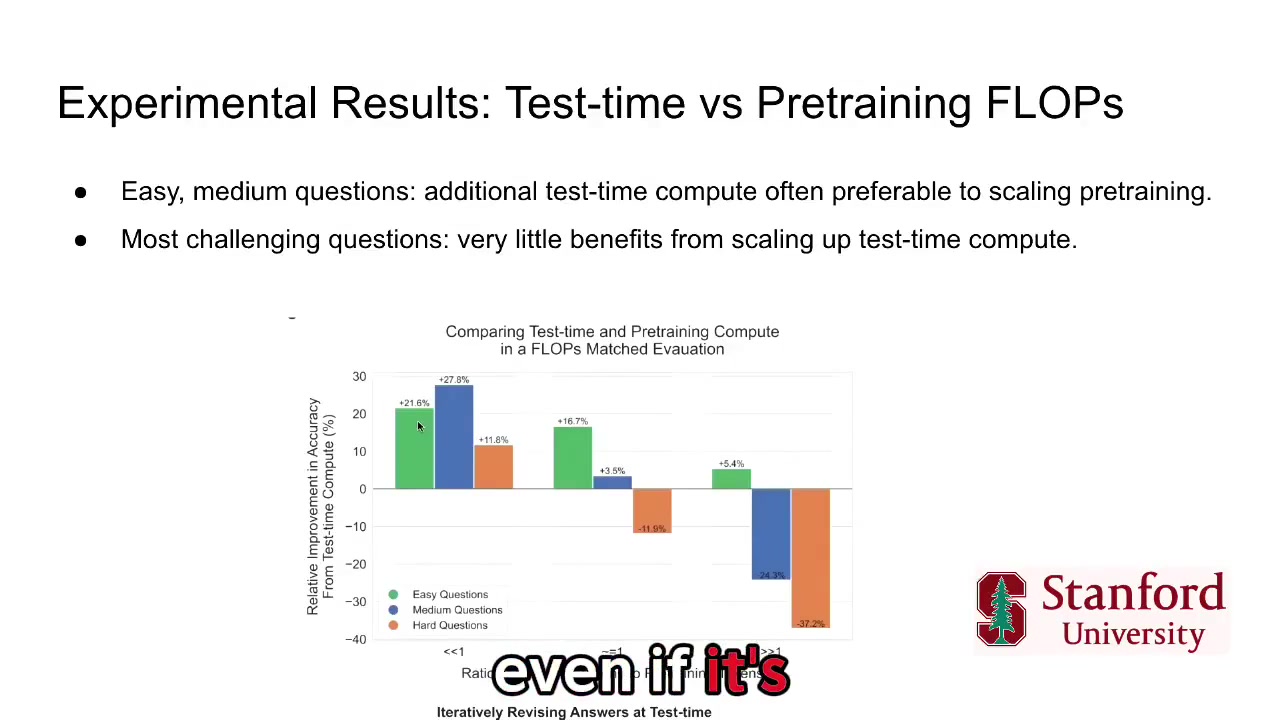
Snell 等人 FLOPs 对齐实验的幻灯结论(口播同步):
- 易 / 中等题:额外 test-time 算力常常比继续砸预训练更划算
- 最难档:test-time 增益很小,甚至相对「把同等 FLOPs 给预训练」更吃亏——更好的基座仍然重要
解读:可执行启发是分流,而不是口号。客服式、有单测的编码任务可以大胆加采样与重试;开放式难题仍应优先模型能力与数据,而不是无限 n=1000。
预算分配可以写成检查表:这题有没有硬校验?有 → 提高并行采样或序列修正轮数;没有 → 先投资更好的基座、更好的过程监督数据,或把题改造成可验证子题。把「推理时算力」当成万能油,会在最难档上浪费钱。
5. Archon:把推理时技巧当成可搜索的架构
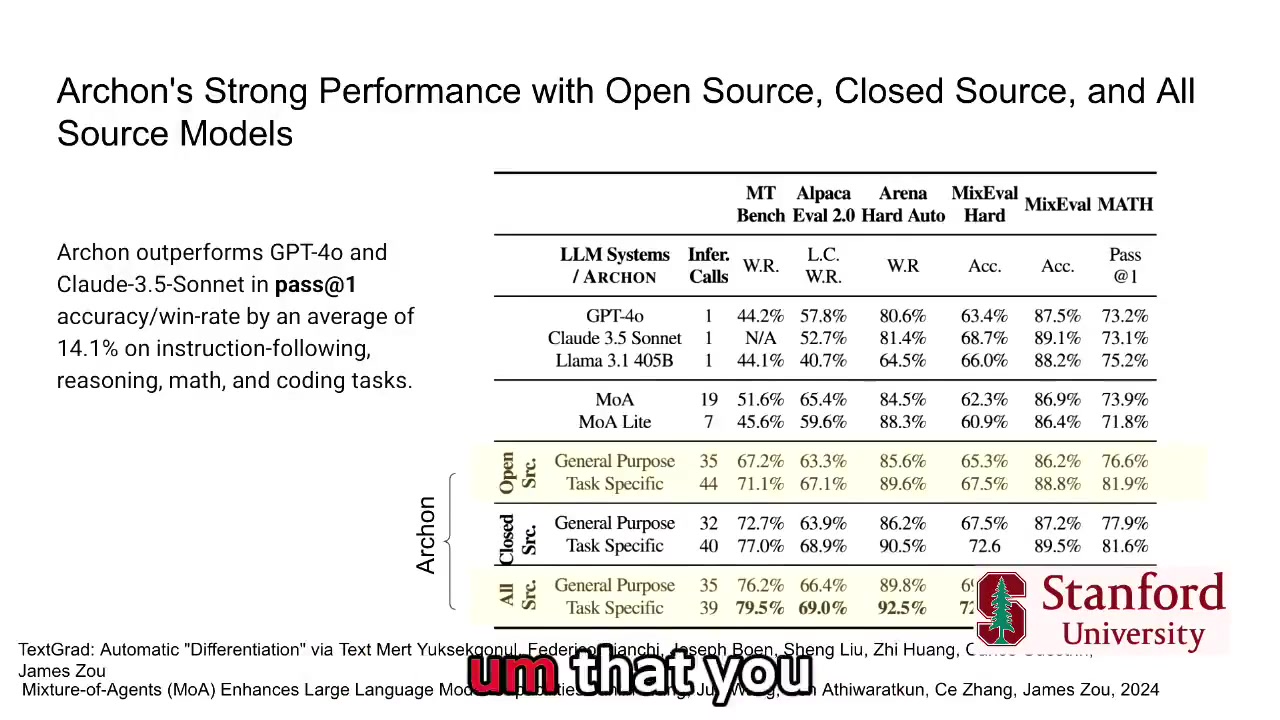
后半段进入 Archon:给定目标基准、推理调用预算、可用模型池与一组推理时组件(重复采样、fusion 把多答案合成一条、critic、verifier、自然语言单测生成与评估等),用搜索拼出「质量–成本」更好的推理架构。幻灯主张:在指令遵循 / 推理 / 数学 / 编码等任务上,Archon 配置相对 GPT-4o、Claude 3.5 Sonnet 的 pass@1 / win-rate 平均约 +14.1%(需注意:这是多调用推理系统相对单次基线,不是「四个 Agent 取代 400 名工程师」)。
片中还演示用 LLM 写「自然语言单元测试」来约束解的空间(括号匹配一类例子)——验证器本身也可以由模型生成,再进入闭环。
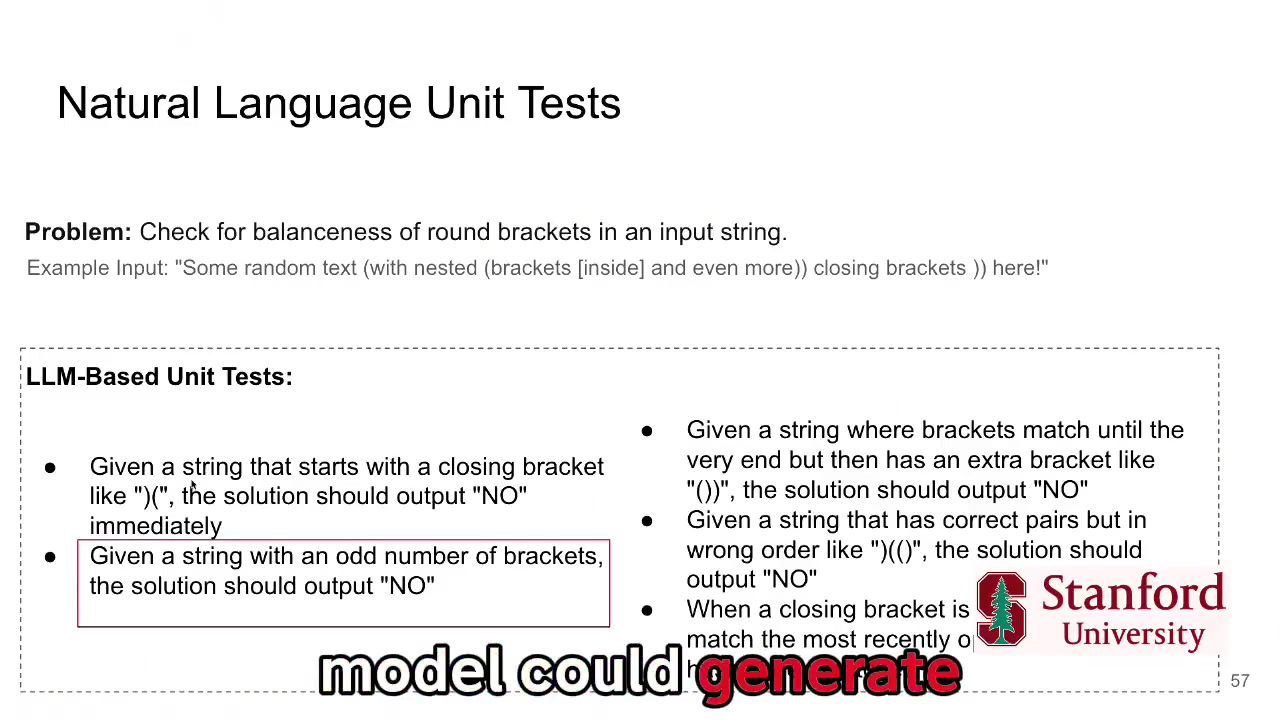
解读:工程上可带走的不是「搜一个万能 Archon」,而是清单:采样宽度 × 序列深度 × 融合/批评 × 验证器来源 × 预算——先把这五个旋钮写进设计文档,再谈「Agent 产品」。
五个旋钮里,最容易被营销话术删掉的是「验证器来源」与「预算」。Archon 的意义是提醒你:推理时技巧可以当架构来搜索,而不是当灵感来堆;但搜索本身也要花调用次数。没有预算上限的「自动架构搜索」,只是把账单从训练挪到推理,并不自动等于利润。
怎么看这条帖
- 正片价值:CS329A 第 2 讲是扎实的 test-time compute 导论;Monkeys / 验证鸿沟 / ORM·PRM / Archon 一条线讲完,适合当「推理时算力」目录页。官方课表与 YouTube 可回源。
- 帖文水分:「18 岁 / Opus 5 / 卖 Anthropic 320 万美元 / 4 Agent 取代 400 工程师」与口播、幻灯、公开收购记录均对不上;同账号历史上有多条金额与买家互换的同构模板(参见 AI Hype Audit 对同类 Anthropic 成交帖的拆解)。
- 关于「Opus 5」:Claude Opus 5 是 Anthropic 于 2026-07-24 发布的真实模型 ID(
claude-opus-5,后有 Opus 5.5);本讲座并不教「用 Opus 5 做一晚卖掉」,片中对比模型多为 GPT-4o、Claude 3.5 Sonnet、Llama 3、DeepSeek、PaLM 2 等当时论文设定。 - 讲者与 Anthropic:Part 1 自我介绍中 Azalia 提及曾在 Anthropic 参与 Claude、在 DeepMind 参与 Gemini——这是履历,不是本片成交叙事的证据。
原文
- X 帖(含本镜像视频):https://x.com/lesliedqbb/status/2115333818207162615
- 官方讲座:Stanford CS329A Part 2 — Test-Time Compute Scaling
- 课程主页:https://cs329a.stanford.edu/